Pourquoi un proxy ne reçoit pas les webhooks : sens de la connexion et solutions alternatives
Sommaire de l'article
- Introduction : pourquoi « j'achète un proxy et je reçois mon webhook » ne marche jamais
- Les bases : le sens de la connexion, ou qui frappe à la porte de qui
- Plongée en profondeur : pourquoi un client proxy n'écoute aucun port et ne fournit aucune adresse publique
- Réseaux mobiles et adresse partagée : pourquoi l'adresse d'un abonné n'est pas adressable de l'extérieur
- Ce qui résout vraiment la réception de webhooks : quatre approches qui fonctionnent
- Le polling comme remplacement du webhook : comment le concevoir pour ne pas buter sur les quotas
- Où le proxy reste utile à côté des webhooks : réponses sortantes et appels à des api tierces
- Tableau « tâche — solution adaptée »
- Erreurs fréquentes : ce qu'il ne faut pas faire
- Cas concrets et résultats : ce que cela donne en pratique
- Faq : questions fréquentes sur les proxys et la réception de webhooks
- Conclusion : le bon modèle mental et les prochaines étapes
Introduction : pourquoi « j'achète un proxy et je reçois mon webhook » ne marche jamais
Le support des services proxy reçoit sans cesse la même demande, formulée de mille façons. « J'ai acheté un proxy mobile, j'ai collé son adresse dans les réglages de l'intégration, et la passerelle de paiement n'envoie aucune notification. » « J'ai mis l'IP du proxy comme URL de webhook dans le CRM, j'obtiens une erreur de connexion. » « Mon script voit tout à travers le proxy, mais personne ne me voit à travers ce même proxy, pourquoi ? » Les formulations varient, la racine est unique : une mauvaise représentation mentale de ce que fait réellement un proxy.
L'attente est compréhensible. Un proxy vous donne « une autre adresse IP », et cette adresse est publique, tous les services de vérification l'affichent. La logique suggère : si j'ai une adresse publique, alors on peut me joindre à cette adresse. C'est faux. Un proxy, y compris le proxy mobile Proxeon, résout la question des requêtes sortantes : votre code initie une connexion, elle passe par un nœud proxy, et le serveur distant voit l'adresse de ce nœud. La tâche inverse, quand un serveur distant initie lui-même une connexion vers vous, un proxy ne la résout pas du tout. Non pas parce qu'il manque quelque chose dans l'offre, mais parce qu'elle est conçue fondamentalement autrement.
Dans cet article, on creuse la question jusqu'au bout. Vous verrez ce qui distingue une connexion sortante d'une connexion entrante au niveau TCP, pourquoi un client proxy n'ouvre pas de port en écoute et ne vous fournit pas une adresse joignable depuis l'extérieur, pourquoi l'adresse d'un abonné mobile n'est par nature pas adressable de l'extérieur, et surtout ce qu'il faut réellement utiliser pour recevoir des webhooks : un serveur avec adresse publique, un tunnel inverse, une file d'événements côté fournisseur ou un polling bien conçu. On verra aussi où le proxy a toute sa place dans ce schéma, et cette place existe. La redirection de ports et la configuration des routeurs domestiques restent hors sujet : c'est un thème voisin, on se contentera d'en marquer la frontière d'applicabilité.
Cet article s'adresse aux développeurs d'intégrations, aux ingénieurs DevOps et aux spécialistes techniques qui construisent de l'automatisation par-dessus des API tierces. Les exemples de code sont en Python et en commandes shell, à reprendre comme base.
Les bases : le sens de la connexion, ou qui frappe à la porte de qui
Commençons par le socle, sans lequel rien n'a de sens. Dans les réseaux TCP/IP, toute connexion a un initiateur et un écouteur. L'initiateur envoie le premier paquet avec le drapeau SYN. L'écouteur a ouvert un port à l'avance, y attend et répond SYN-ACK. C'est seulement après cette poignée de main que les données circulent dans les deux sens. Le mot clé ici, c'est « à l'avance » : l'écouteur doit déjà se trouver sur une adresse routable depuis Internet, et déjà tenir un port ouvert au moment où l'initiateur décide de frapper.
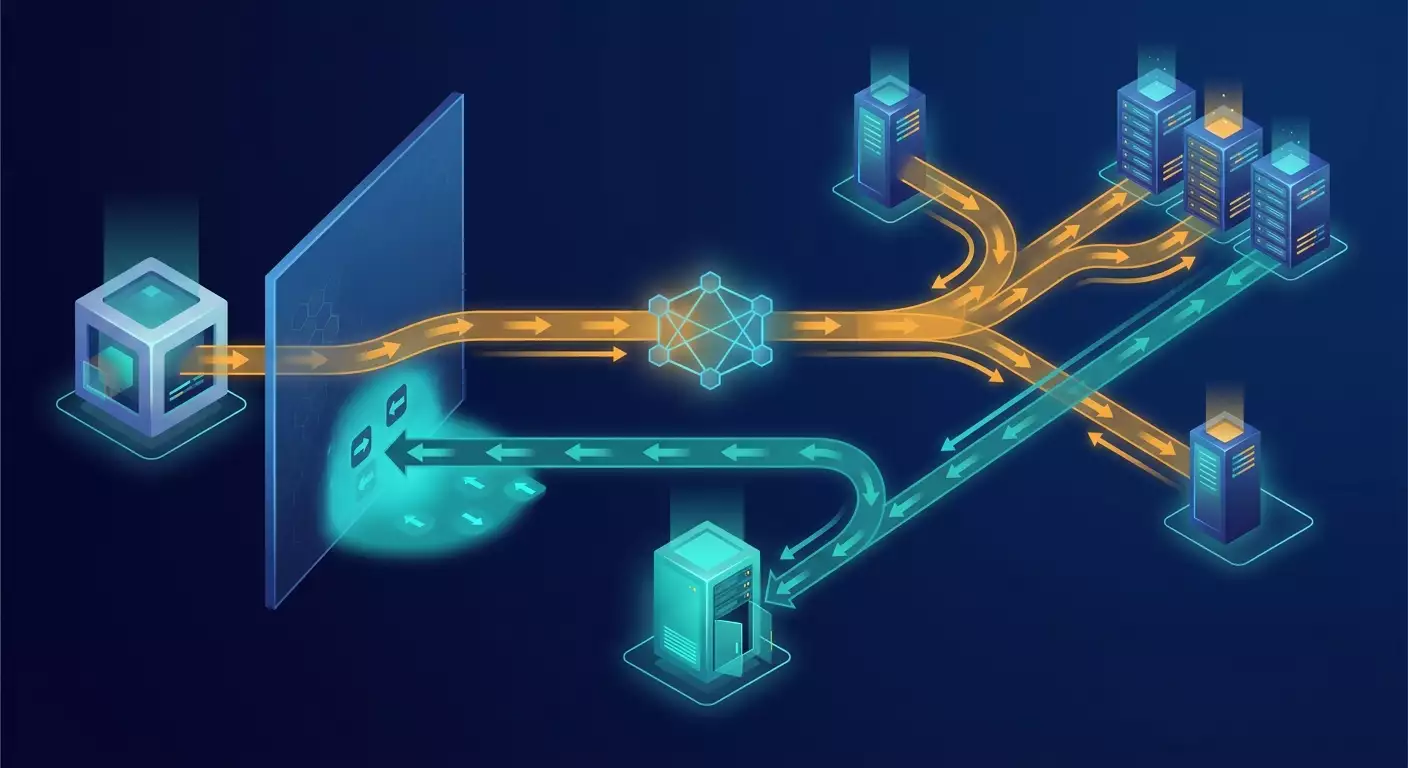
Schéma d'une requête sortante via un proxy
Représentons le schéma sous forme textuelle. Votre script tourne chez vous ou au bureau derrière un NAT, ou même sur un portable avec modem mobile.
- Étape 1. Votre script initie une connexion vers le nœud proxy : [votre code] frappe à [nœud Proxeon].
- Étape 2. Le nœud proxy initie en son nom une connexion vers le site cible : [nœud Proxeon] frappe à [api.example.com].
- Étape 3. Le site cible répond par la connexion déjà ouverte, en sens inverse, le nœud proxy transmet la réponse par votre connexion ouverte.
Remarquez : la réponse du serveur n'est pas une connexion entrante. Ce sont des données qui reviennent par le canal que vous avez ouvert. C'est vous qui avez ouvert la porte, c'est vous qui la tenez pendant l'échange. Dès que vous fermez la connexion, il n'y a plus de chemin retour. Personne à l'extérieur ne peut « poursuivre la conversation » de sa propre initiative.
Schéma d'un webhook
Maintenant, le webhook. Un fournisseur de paiement, une messagerie, un CRM ou une marketplace veulent vous signaler un événement : paiement effectué, message reçu, statut de commande modifié.
- Étape 1. Le fournisseur prend l'URL que vous avez indiquée lors de l'abonnement, résout le nom de domaine en adresse IP.
- Étape 2. Le fournisseur initie une connexion vers cette adresse sur le port 443 : [serveur du fournisseur] frappe à [votre URL].
- Étape 3. À cette adresse et sur ce port, quelqu'un doit écouter, accepter la poignée de main TLS avec un certificat valide, analyser la requête HTTP et répondre avec un code 2xx.
Ici, l'initiateur, c'est le fournisseur. L'écouteur, c'est vous. Et voilà la question à laquelle tout l'article répond : quelle adresse allez-vous donner au fournisseur ? L'adresse du proxy ? Mais le nœud proxy n'écoute pas pour vous. L'adresse de votre connexion domestique ? Elle est soit privée, soit derrière le NAT de l'opérateur. Le portable avec modem ? Il n'a carrément aucune adresse routable.
Une analogie qui remet tout en place
Un proxy, c'est comme un service de coursier pour le courrier sortant. Vous confiez une lettre au coursier, il la porte au destinataire, et sur l'enveloppe figure l'adresse de retour du bureau du coursier, pas votre adresse personnelle. Le destinataire peut glisser sa réponse dans la même enveloppe, le coursier reviendra et vous la remettra, parce qu'il se souvient de qui lui a confié la lettre. Mais si le destinataire veut vous écrire lui-même une semaine plus tard, il écrira à l'adresse du bureau. Le bureau recevra la lettre sans savoir à lequel de ses milliers de clients elle est destinée. Elle n'arrivera probablement même jamais à la boîte du bureau, car il n'y a pas de boîte de réception là-bas. Pour recevoir du courrier, il vous faut votre propre adresse postale, pas un service d'envoi sortant.
Plongée en profondeur : pourquoi un client proxy n'écoute aucun port et ne fournit aucune adresse publique
Descendons au niveau des protocoles. Il existe deux grandes familles de proxys : les proxys HTTP et les proxys SOCKS. Voyons ce que chacune sait faire, et constatons que les connexions entrantes vers votre service ne figurent dans cette liste ni sur le papier ni en pratique.
Comment fonctionne un proxy HTTP
Un proxy HTTP reçoit du client une requête de la forme GET http://host/path ou, pour HTTPS, la commande CONNECT host:443. Dans ce second cas, le proxy ouvre une connexion TCP vers l'hôte cible puis se contente de relayer les octets dans les deux sens, sans regarder à l'intérieur du trafic chiffré. C'est tout. Le protocole ne prévoit aucune commande « commence à écouter un port pour moi » ni « enregistre-moi une adresse ». Le client est toujours l'initiateur, le proxy toujours l'intermédiaire dans le sens « du client vers le monde ».
Voici un exemple minimal de requête sortante via un proxy en Python. Il fonctionne parce que le sens est correct :
import requests

PROXY = 'http://user:pass@gate.proxeon.net:PORT'
proxies = {'http': PROXY, 'https': PROXY}

r = requests.get('https://api.example.com/v1/status', proxies=proxies, timeout=(5, 30))
print(r.status_code, r.json())
Et voici la tentative condamnée d'avance. Supposez que vous ayez découvert l'IP externe du proxy, par exemple via un service de vérification d'adresse, et que vous décidiez de l'indiquer comme URL de webhook :
curl -v --max-time 10 http://203.0.113.45/webhook
# résultat : connect() timed out ou Connection refused
Pourquoi ? Sur l'adresse 203.0.113.45 tourne un logiciel proxy qui écoute son port de service pour recevoir les commandes des clients, mais pas votre chemin /webhook. Même si quelque chose répondait sur le port 80, ce ne serait pas votre code. Votre code est sur une autre machine, derrière une autre adresse, et le serveur proxy n'a aucune idée que la requête sur le chemin /webhook doit être renvoyée précisément à vous, et non à l'un des centaines d'autres clients qui partagent la même adresse de sortie.
Et SOCKS5, avec sa commande BIND ?
Ici commence la partie la plus intéressante, que peu connaissent. La spécification SOCKS5 décrit bel et bien trois commandes : CONNECT, BIND et UDP ASSOCIATE. La commande BIND était prévue exactement pour le scénario inverse : le client demande au proxy d'ouvrir un port en écoute, puis d'accepter une connexion entrante et de la transmettre au client. C'est un héritage du protocole FTP en mode actif, où le serveur doit se connecter au client pour transférer les données.
On pourrait croire la solution trouvée. Mais trois raisons font que BIND ne vous aidera pas en pratique :
- BIND accepte exactement une connexion entrante, et uniquement après que vous avez déjà établi une connexion sortante vers le même hôte. Ce n'est pas « écouter en permanence pour n'importe qui », mais « ouvre la porte à un interlocuteur précis avec qui je suis déjà en train de parler ».
- La grande majorité des serveurs proxy commerciaux n'implémentent pas la commande BIND, ou la désactivent pour des raisons de sécurité. Un port en écoute ouvert sur un nœud partagé par des centaines de clients, c'est un vecteur d'attaques et une source d'abus, donc elle n'existe tout simplement pas.
- Même là où BIND existe, l'adresse et le port sont alloués dynamiquement, pour une courte durée, et ne conviennent en rien pour être enregistrés comme URL de webhook avec un certificat TLS.
Bilan : la possibilité théorique existe dans la spécification, mais elle n'a aucune utilité pratique pour recevoir des webhooks.
Ce que vous obtenez avec un proxy, et ce que vous n'obtenez pas
Formulons cela sans ambiguïté. En achetant un proxy, vous obtenez :
- une adresse IP de sortie que voient les serveurs distants lors de vos requêtes sortantes ;
- l'appartenance géographique et réseau de cette adresse, par exemple une adresse issue du pool d'un opérateur mobile d'une région donnée ;
- la possibilité de faire tourner cette adresse ou, au contraire, de la garder stable pendant une session ;
- une répartition du trafic sortant sur différents canaux si vous gérez plusieurs intégrations indépendantes.
Vous n'obtenez pas :
- de port en écoute sur l'adresse de sortie ;
- d'adresse routable vers laquelle des tiers peuvent initier une connexion ;
- de nom de domaine ni de certificat TLS liés à votre service ;
- de garantie que l'adresse de sortie sera la même dans une heure, si l'offre prévoit une rotation.
Une fois ce tableau intégré, la question « pourquoi le webhook n'arrive pas sur le proxy » cesse d'être une question. Elle devient une évidence.
Réseaux mobiles et adresse partagée : pourquoi l'adresse d'un abonné n'est pas adressable de l'extérieur
Les réseaux mobiles méritent un développement à part, car ce sont le plus souvent les proxys mobiles qui tiennent le rôle principal dans les histoires de « mon webhook n'arrive pas ». Ici, aux limites du proxy lui-même s'ajoute l'architecture du réseau de l'opérateur, qui amplifie l'effet plusieurs fois.
Pénurie d'adresses et CGNAT
Il existe environ quatre milliards d'adresses IPv4 publiques dans le monde, alors que les connexions mobiles actives sont nettement plus nombreuses. Aucun opérateur ne peut attribuer à chaque abonné sa propre adresse publique. C'est pourquoi les opérateurs utilisent le Carrier-Grade NAT (CGNAT, traduction d'adresses au niveau de l'opérateur). L'appareil de l'abonné reçoit une adresse privée dans la plage spécialement réservée 100.64.0.0/10 ou dans la classique 10.0.0.0/8, tandis qu'à la frontière du réseau se trouve une puissante passerelle NAT qui traduit des milliers d'adresses d'abonnés en une ou quelques adresses publiques.
Comment cela se traduit-il du point de vue de l'adressabilité ? Quand votre modem envoie un paquet vers l'extérieur, la passerelle inscrit dans sa table : « abonné 100.72.14.9, port 51234 → adresse publique 203.0.113.45, port 40001 ». La réponse arrivant sur 203.0.113.45:40001 est associée à cette entrée et vous est renvoyée. Mais les entrées ne sont créées que par le trafic sortant et ne vivent que quelques secondes ou minutes sans activité. Si quelqu'un de l'extérieur envoie un paquet vers 203.0.113.45 sur le port 443, aucune entrée correspondante n'existera dans la table. La passerelle le rejettera. Non pas qu'elle le « bloque », mais elle ne pourra pas déterminer auquel des mille abonnés il est destiné.
Pourquoi c'est insoluble côté abonné
Avec un fournisseur d'accès domestique, c'est parfois différent : certaines offres attribuent une véritable adresse publique au routeur, et là se pose le thème voisin de la redirection de ports et de la configuration du routeur. On ne le décrit volontairement pas, on se contente de fixer la frontière d'applicabilité : la redirection de ports n'a de sens que là où votre équipement porte une véritable adresse routable. Dans un réseau mobile, l'abonné n'a par principe aucune adresse de ce type, il n'y a rien à rediriger ni vers où, et la configuration de l'équipement n'y change rien. L'option d'adresse publique pour un abonné mobile, chez la plupart des opérateurs, soit n'existe pas, soit est fournie comme un service entreprise séparé, ce qui n'a plus rien à voir avec un proxy.
Couches supplémentaires : rotation et filtrage
Au CGNAT s'ajoutent deux autres facteurs. D'abord, l'adresse publique par laquelle sort l'abonné change périodiquement : à la reconnexion, lors d'un rééquilibrage de charge, au changement de station de base. Les proxys mobiles Proxeon exploitent justement cette propriété comme un atout : l'adresse peut être renouvelée selon un planning ou à la demande. Mais pour recevoir des webhooks, la stabilité de l'adresse est critique, et ici elle est absente par définition. Ensuite, les opérateurs filtrent une partie du trafic entrant à la frontière du réseau, parce que les appareils des abonnés ne sont pas conçus pour être des serveurs. Même là où un abonné obtient une adresse IPv6 publique, les connexions entrantes vers elle sont souvent fermées par le pare-feu de l'opérateur.
La conclusion de ce chapitre mérite d'être soulignée : l'adresse d'un proxy mobile est une identité de sortie, pas l'adresse d'un service. Ce n'est pas un défaut du produit, c'est sa nature. On achète un proxy mobile pour que les requêtes sortantes ressemblent au trafic d'un abonné ordinaire d'un opérateur et d'une région donnés. Et précisément parce que ce trafic est indiscernable de celui d'un abonné, il a hérité aussi de la non-adressabilité de l'abonné depuis l'extérieur.
Ce qui résout vraiment la réception de webhooks : quatre approches qui fonctionnent
Passons du diagnostic au traitement. Il existe quatre méthodes éprouvées pour recevoir des événements de systèmes externes quand votre code vit derrière un NAT, derrière un modem mobile ou même sur un portable. Chacune a sa niche, son coût et ses limites. Examinons-les dans l'ordre, avec des exemples.
Approche 1. Un serveur avec adresse publique
La méthode la plus directe et la plus fiable. Vous louez un serveur virtuel chez un hébergeur, vous recevez avec lui une adresse IPv4 publique, vous y associez un nom de domaine, vous émettez un certificat TLS et vous lancez un récepteur. En 2026, les fournisseurs de webhooks exigent presque tous HTTPS avec un certificat valide, cette étape est donc obligatoire.
Plan étape par étape :
- Louez un VPS de configuration minimale dans une juridiction conforme à vos exigences de stockage de données.
- Créez un enregistrement A pour un domaine du type
hooks.yourdomain.tld, pointant vers l'adresse du serveur. - Installez un reverse proxy web (nginx ou équivalent) et émettez un certificat via un client ACME.
- Lancez votre application réceptrice sur un port local, fermé à l'extérieur, et faites pointer le serveur web vers elle.
- Configurez la vérification de signature et la file de traitement pour répondre rapidement au fournisseur.
Exemple de récepteur en Flask avec vérification de signature HMAC et réponse rapide. On reporte le traitement lourd dans une file, car la plupart des fournisseurs attendent une réponse en 5 à 10 secondes maximum :
import hmac, hashlib, json, os
from flask import Flask, request, abort
from queue import Queue

app = Flask(__name__)
SECRET = os.environ['WEBHOOK_SECRET'].encode()
jobs = Queue()

def valid_signature(raw_body, header_sig):
expected = hmac.new(SECRET, raw_body, hashlib.sha256).hexdigest()
return hmac.compare_digest(expected, header_sig or '')

@app.post('/webhook/payments')
def payments():
raw = request.get_data()
if not valid_signature(raw, request.headers.get('X-Signature')):
abort(401)
event = json.loads(raw)
jobs.put(event) # traitement en arrière-plan, réponse immédiate
return '', 200
Notez trois détails. La signature se vérifie sur le corps brut de la requête, pas sur le JSON parsé, sinon le moindre reformatage casse la comparaison. La comparaison se fait via compare_digest, pour ne pas laisser fuiter le temps de comparaison. La réponse 200 est renvoyée avant le traitement, et l'événement part dans la file. Si le fournisseur ne reçoit pas de 2xx dans le délai imparti, il considérera la livraison comme échouée et commencera les relances, et vous récupérerez des doublons.
Approche 2. Le tunnel inverse
Si le code doit absolument s'exécuter sur votre machine locale et non sur un serveur, utilisez un tunnel inverse. L'idée est élégante et parfaitement cohérente avec tout ce qu'on a vu plus haut : votre machine initie elle-même une connexion sortante vers un serveur public, et celui-ci se met à écouter un port en votre nom et à aiguiller les requêtes entrantes dans le canal déjà ouvert. Le sens d'initiation est sortant, donc ni le NAT ni le CGNAT ne le gênent. L'écouteur public se trouve sur le serveur, donc le fournisseur de webhooks peut l'atteindre.
Implémentation la plus simple via SSH. Sur le serveur public, la configuration sshd doit activer l'option GatewayPorts ou bien on utilise un serveur web local comme front. Depuis la machine locale :
# le récepteur local écoute sur 127.0.0.1:8080
# on demande au serveur d'écouter sur 127.0.0.1:9000 et d'aiguiller le trafic vers nous
ssh -N -R 9000:127.0.0.1:8080 tunnel@hooks.yourdomain.tld

# sur le serveur, nginx proxifie https://hooks.yourdomain.tld/webhook -> 127.0.0.1:9000
Pour un usage industriel, un simple processus ssh n'est pas assez fiable : la connexion peut tomber. Utilisez un wrapper avec reconnexion automatique (autossh ou un superviseur équivalent) et activez ServerAliveInterval pour détecter les coupures en quelques secondes. Il existe aussi des services de tunnel spécialisés et des solutions auto-hébergées basées sur le même principe, avec émission automatique de certificats et interface web. Le principe est partout le même : l'agent local maintient une connexion sortante, le côté public reçoit les webhooks.
Les limites de l'approche méritent d'être gardées en tête. Tant que le tunnel est rompu, les webhooks sont perdus ou partent en relance chez le fournisseur. Les adresses temporaires de certains services de tunnel changent au redémarrage, ce qui est inadmissible en production : il faut un domaine fixe. Et le tunnel ajoute de la latence et un point de défaillance. Pour le développement et le débogage, c'est un outil idéal, pour l'exploitation il ne convient qu'associé à une supervision.
Approche 3. La file d'événements côté fournisseur
Beaucoup d'API matures offrent une alternative au modèle push : les événements s'accumulent dans un journal ou une file côté fournisseur, et vous les récupérez quand cela vous arrange. Cela inverse le sens de la connexion en sortant pour vous, et tout le problème d'adressabilité disparaît.
L'exemple canonique est le Bot API d'une messagerie avec la méthode getUpdates : le serveur conserve les mises à jour non lues pendant 24 heures, et le client les récupère périodiquement en transmettant l'offset de la dernière traitée. Des mécanismes similaires existent chez les systèmes de paiement sous forme de liste d'événements avec curseur, chez les marketplaces sous forme de file de modifications de commandes, chez les fournisseurs cloud sous forme de files de messages managées où l'on peut diriger des webhooks et que le client vient vider.
import requests, time

TOKEN = 'your-bot-token'
BASE = f'https://api.messenger.example/bot{TOKEN}'
offset = 0

while True:
resp = requests.get(f'{BASE}/getUpdates',
params={'offset': offset, 'timeout': 50},
timeout=60)
for upd in resp.json().get('result', []):
handle(upd)
offset = upd['update_id'] + 1
Le paramètre timeout=50 active ici le long polling : le serveur garde la connexion ouverte jusqu'à l'arrivée d'un événement ou l'expiration du délai, et vous obtenez une livraison quasi instantanée sans multiplier les requêtes vides. C'est une connexion sortante, elle fonctionne sans problème derrière un NAT, derrière un modem mobile et, si besoin, via un proxy.
Si le fournisseur n'offre pas de file intégrée, on peut la construire soi-même à partir de la première approche : un récepteur minimal sur VPS reçoit les webhooks et les dépose dans une file de messages, et votre machine locale vient vider la file. On obtient un hybride qui combine la fiabilité de l'adresse publique avec la souplesse de l'exécution locale.
Approche 4. Le polling à la place de l'abonnement
Quand le fournisseur n'offre ni webhooks ni file d'événements, il reste le polling classique de l'état : vous interrogez régulièrement une ressource et vous comparez avec l'état précédent. C'est l'approche la plus universelle, car elle n'exige du fournisseur rien de plus qu'une API de lecture classique. Mais c'est aussi la plus exigeante en conception : une boucle naïve à intervalle fixe se heurte vite aux quotas, gaspille son budget en réponses vides et prend du retard sur les événements. La section suivante est entièrement consacrée à comment l'éviter.
Les outils utiles
- Un serveur web en front (nginx ou équivalent) pour la terminaison TLS et le routage vers l'application.
- Un client ACME pour l'émission et le renouvellement automatiques des certificats.
- Une file de messages (Redis Streams, RabbitMQ ou une file managée du cloud) pour tamponner les événements entre la réception et le traitement.
- Un superviseur de tunnel avec reconnexion automatique pour les tunnels inverses.
- Un inspecteur de requêtes local pour le débogage : n'importe quel serveur HTTP minimal qui journalise les en-têtes et le corps vous montrera ce que le fournisseur envoie exactement.
- Un proxy Proxeon pour les appels sortants vers des API tierces depuis les gestionnaires, ce que l'on détaille plus bas.
Le polling comme remplacement du webhook : comment le concevoir pour ne pas buter sur les quotas
On critique le polling pour son gaspillage, souvent à juste titre. Mais ce n'est pas le polling en soi qui gaspille, c'est sa mauvaise implémentation. Un poller bien conçu a une charge sur l'API comparable à celle des webhooks et il est même plus fiable, car il ne dépend pas de la joignabilité des connexions entrantes. Examinons les principes.
Principe 1. Un curseur au lieu d'une sélection complète
Ne demandez jamais « toutes les commandes » et ne cherchez pas les changements de votre côté. Utilisez les paramètres du type since, updated_after, cursor ou page_token, présents dans presque toutes les API modernes. Persistez le dernier curseur pour qu'un redémarrage du processus ne provoque pas un rechargement complet de l'historique. La réponse par curseur est petite, se traite vite et ne crée pas de charge chez le fournisseur.
Principe 2. Les requêtes conditionnelles
Si la ressource prend en charge les en-têtes ETag et If-None-Match, ou Last-Modified et If-Modified-Since, utilisez-les. Une réponse 304 Not Modified n'a pas de corps et n'est souvent pas comptée dans le quota, ou l'est à tarif réduit. C'est un moyen gratuit de diviser le trafic par plusieurs.
Principe 3. Un intervalle adaptatif avec jitter
Un intervalle fixe a deux défauts : aux heures creuses il gaspille des requêtes, aux pics il prend du retard. Le schéma adaptatif est simple : après une réponse vide, augmentez l'intervalle (par exemple en le multipliant par 1,5 jusqu'à un plafond), après une réponse non vide, réinitialisez au minimum. Ajoutez une variation aléatoire de 10 à 20 % pour que plusieurs de vos instances ne tapent pas l'API en même temps.
Principe 4. Le respect des signaux du serveur
Les en-têtes Retry-After, X-RateLimit-Remaining et X-RateLimit-Reset n'existent pas pour faire joli. Après un 429, attendez exactement le temps indiqué. Si vous voyez le quota restant passer sous un seuil, ralentissez à l'avance. Ce n'est pas seulement de la politesse, c'est aussi une protection contre des blocages temporaires de clé.
Principe 5. L'idempotence du traitement
Le polling peut par nature renvoyer deux fois le même événement : à la frontière du curseur, après un incident, lors du chevauchement de fenêtres. Chaque événement doit avoir un identifiant unique, et le gestionnaire doit tenir une table des identifiants déjà traités avec une durée de conservation raisonnable. Cette même règle protège aussi des doublons de webhooks lors des relivraisons.
Un squelette prêt à l'emploi de poller adaptatif
import random, time, requests

MIN_INTERVAL, MAX_INTERVAL = 5, 300
interval = MIN_INTERVAL
cursor = load_cursor() # depuis une BDD ou un fichier
etag = None
seen = SeenStore(ttl_hours=48) # stockage des id déjà traités

while True:
headers = {'If-None-Match': etag} if etag else {}
r = requests.get('https://api.example.com/v1/events',
 params={'cursor': cursor, 'limit': 100},
 headers=headers, timeout=(5, 30))

if r.status_code == 429:
time.sleep(int(r.headers.get('Retry-After', 60)))
continue
if r.status_code == 304:
interval = min(interval * 1.5, MAX_INTERVAL)
elif r.ok:
etag = r.headers.get('ETag')
events = r.json()['data']
for ev in events:
if not seen.contains(ev['id']):
handle(ev)
seen.add(ev['id'])
if events:
cursor = r.json()['next_cursor']
save_cursor(cursor)
interval = MIN_INTERVAL
else:
interval = min(interval * 1.5, MAX_INTERVAL)

remaining = int(r.headers.get('X-RateLimit-Remaining', 1000))
if remaining < 50:
interval = max(interval, 60)

time.sleep(interval * random.uniform(0.9, 1.2))
Check-list de conception du polling
- Le curseur ou l'horodatage est persisté et survit au redémarrage.
- Les requêtes conditionnelles sont utilisées si l'API les prend en charge.
- L'intervalle est adaptatif, avec plafond et jitter.
- Le code 429 et l'en-tête Retry-After sont traités explicitement.
- Chaque événement est traité de façon idempotente via un identifiant unique.
- Les délais de connexion et de lecture sont définis explicitement et séparément.
- Métriques : fréquence des requêtes, part de réponses vides, latence entre événement et traitement.
- Si le fournisseur prend en charge le long polling, il est activé et le polling classique désactivé.
Avec une telle conception, un poller dont l'intervalle minimal est de 5 secondes monte à 5 minutes en période creuse et effectue environ 300 requêtes par jour et par ressource. C'est des dizaines de fois moins qu'une boucle naïve toutes les 10 secondes, qui fait 8 640 requêtes par jour avec la même latence moyenne de livraison aux heures actives.
Où le proxy reste utile à côté des webhooks : réponses sortantes et appels à des API tierces
Il serait faux de conclure que « le proxy n'a rien à voir avec les webhooks ». Il a à voir, et de manière très concrète, simplement de l'autre côté du schéma. Après avoir reçu un événement, votre gestionnaire fait presque toujours des requêtes sortantes : il confirme l'opération, redemande les détails de la commande, envoie des données dans un autre système, notifie un utilisateur. Toutes ces requêtes sont sortantes, et c'est là que le proxy est à sa place.
Scénario 1. Vérification de l'événement par une requête retour
Une bonne pratique de sécurité : ne pas faire aveuglément confiance au corps du webhook, mais après vérification de la signature, redemander l'objet au fournisseur via son identifiant. Cette requête part de votre serveur vers l'API du fournisseur. Si le fournisseur restreint l'accès par région ou fait une analyse comportementale de la source, une adresse de sortie stable issue de la bonne région via Proxeon rend le profil de trafic prévisible.
Scénario 2. Appels à des API tierces depuis le gestionnaire
Le gestionnaire d'un webhook de marketplace peut appeler l'API d'un service de livraison, d'un service de vérification d'entreprise, d'une API cartographique. Chacune a ses propres quotas par adresse IP. Répartir les intégrations sur différentes adresses de sortie les isole les unes des autres : l'épuisement du quota d'une intégration ne paralyse pas les autres.
Scénario 3. Séparation de l'identité du trafic sortant
Quand un même serveur sert plusieurs clients ou projets indépendants, il est utile que leur trafic sortant vers des API externes parte d'adresses différentes. Cela simplifie le diagnostic (l'adresse montre à qui appartient la requête) et réduit le risque que les problèmes d'un projet touchent les autres.
Exemple : récepteur en direct, sortant via proxy
La règle d'or : le récepteur de webhooks écoute directement sur l'adresse publique, et le proxy ne sert qu'aux appels sortants. N'essayez pas de « faire passer » le récepteur par un proxy, c'est absurde pour toutes les raisons vues plus haut.
import requests
from flask import Flask, request

app = Flask(__name__)

OUT_PROXY = 'http://user:pass@gate.proxeon.net:PORT'
outbound = requests.Session()
outbound.proxies = {'http': OUT_PROXY, 'https': OUT_PROXY}

@app.post('/webhook/orders')
def orders():
event = request.get_json()
# la réception se fait en direct, sans proxy
order_id = event['order_id']
# vérification sortante et appels à des API tierces - via le proxy
full = outbound.get(f'https://api.marketplace.example/orders/{order_id}',
timeout=(5, 20)).json()
outbound.post('https://api.delivery.example/shipments',
 json={'order': full}, timeout=(5, 20))
return '', 200
Quelques remarques pratiques. Gardez une Session dédiée aux appels sortants, pour que les réglages du proxy ne fuitent pas ailleurs dans l'application. Définissez les délais explicitement : via un proxy, le chemin est plus long, et un appel sortant bloqué ne doit pas retarder la réponse au fournisseur de webhook. Idéalement, faites les appels sortants non pas dans le gestionnaire de requête HTTP, mais dans un worker en arrière-plan qui vide la file. Et si l'API tierce exige d'inscrire votre adresse dans une liste d'autorisation, utilisez une offre avec adresse de sortie statique plutôt que rotative.
Tableau « tâche — solution adaptée »
Récapitulons dans un mémo unique. Pour chaque tâche type, on indique si un proxy la résout, et quoi utiliser à la place ou en complément.
- Tâche : faire des requêtes sortantes vers des API externes depuis une région ou un opérateur donné. Solution : proxy Proxeon, offre statique ou rotative selon le besoin. Rôle du proxy : principal.
- Tâche : recevoir des webhooks d'une passerelle de paiement en production. Solution : un VPS avec adresse publique, un domaine, TLS, un récepteur avec vérification de signature et file. Rôle du proxy : uniquement pour les appels sortants depuis le gestionnaire.
- Tâche : déboguer la réception de webhooks sur la machine locale d'un développeur. Solution : tunnel inverse vers un serveur public avec domaine fixe. Rôle du proxy : aucun.
- Tâche : recevoir des événements d'une messagerie ou d'une API avec file, le code s'exécutant à la maison ou derrière un modem mobile. Solution : long polling de méthodes du type getUpdates, vidage de la file du fournisseur. Rôle du proxy : optionnel pour les requêtes sortantes.
- Tâche : surveiller les changements d'une API sans webhooks ni files. Solution : polling adaptatif avec curseur, requêtes conditionnelles et respect des quotas. Rôle du proxy : répartir la charge sur différentes adresses de sortie dans les limites du fournisseur.
- Tâche : recevoir des webhooks sur une machine connectée via un modem mobile. Solution : impossible en direct à cause du CGNAT ; utilisez un tunnel inverse ou une file. Rôle du proxy : aucun.
- Tâche : plusieurs intégrations sur un même serveur ne doivent pas se gêner sur les quotas d'API tierces. Solution : adresses de sortie Proxeon distinctes par intégration, plus des files séparées. Rôle du proxy : principal pour la partie sortante.
- Tâche : une API tierce exige d'inscrire l'adresse dans une liste d'autorisation. Solution : adresse de sortie statique ; pour la réception de webhooks, adresse publique de votre serveur. Rôle du proxy : offre statique pour la partie sortante.
- Tâche : obtenir une adresse publique sur un routeur domestique. Solution : thème voisin, dépend du fournisseur d'accès ; ne s'applique qu'en présence d'une véritable adresse publique sur l'équipement. Rôle du proxy : aucun.
Erreurs fréquentes : ce qu'il ne faut pas faire
Rassemblons les pièges sur lesquels on tombe le plus souvent. Certains coûtent des heures de débogage, d'autres des paiements perdus.
Erreur 1. Indiquer l'adresse du proxy comme URL de webhook
On l'a détaillé plus haut, mais répétons : sur l'adresse de sortie du proxy, il n'y a pas votre écouteur. Le fournisseur obtiendra un timeout ou un refus de connexion et, après plusieurs échecs, désactivera l'abonnement. Certains fournisseurs, en cas d'erreurs répétées, bloquent l'URL pour une longue durée.
Erreur 2. Indiquer une adresse locale ou privée
Une URL du type http://192.168.1.10:8080/hook ou http://localhost/hook n'est routable qu'à l'intérieur de votre réseau. Le fournisseur ne peut physiquement pas l'atteindre. Beaucoup rejettent d'emblée ces URL à l'enregistrement de l'abonnement, mais pas tous.
Erreur 3. Un certificat auto-signé ou du HTTP simple
Les fournisseurs de webhooks vérifient le certificat. Un certificat auto-signé ou expiré entraîne un refus silencieux de livraison. Le HTTP simple sans TLS, la plupart des fournisseurs ne l'admettent pas du tout.
Erreur 4. Un traitement long dans le gestionnaire HTTP
Si le gestionnaire tire des données de trois API externes et écrit en base avant de répondre au fournisseur, il dépasse facilement le délai d'attente. Le fournisseur considère la livraison comme échouée et relance. Vous traitez le même événement plusieurs fois. La réponse doit partir en quelques centaines de millisecondes, le traitement va dans la file.
Erreur 5. Absence d'idempotence
Les relivraisons sont la norme, pas l'exception. Sans prise en compte des identifiants déjà traités, vous créerez deux fois une commande, enverrez deux fois une notification ou passerez deux fois un débit en comptabilité.
Erreur 6. Faire aveuglément confiance au corps du webhook
Une URL publique est accessible à tous. Sans vérification de signature, n'importe qui peut vous envoyer un faux événement « paiement effectué ». Vérifiez le HMAC et, pour les opérations critiques, redemandez l'objet au fournisseur.
Erreur 7. Une adresse de tunnel temporaire en production
Un domaine généré aléatoirement par un service de tunnel change au redémarrage. L'abonnement du fournisseur reste lié à l'ancienne URL. Les événements se perdent jusqu'à ce que quelqu'un s'en aperçoive. En exploitation, un tunnel n'est acceptable qu'avec un domaine fixe et de la supervision.
Erreur 8. Un polling à intervalle court fixe
Une fois par seconde sans curseur ni requêtes conditionnelles, c'est la voie directe vers le 429 et le blocage temporaire de clé. Pire : pendant le blocage, vous ne recevez plus rien du tout, et la latence de livraison devient infinie.
Erreur 9. Des appels sortants via proxy sans délais
Le proxy ajoute un nœud intermédiaire. Sans délais explicites, un appel sortant bloqué immobilise un worker et, s'il est fait dans le gestionnaire HTTP, fait aussi échouer la réponse au fournisseur. Définissez toujours le délai de connexion et de lecture séparément.
Erreur 10. Croire que la commande BIND de SOCKS5 fera de vous un serveur
On la rencontre chez ceux qui ont lu la spécification. Sur les nœuds commerciaux, la commande n'est en général pas implémentée, et là où elle l'est, elle donne une connexion unique et de courte durée. Inutilisable pour des webhooks.
Cas concrets et résultats : ce que cela donne en pratique
Trois histoires, tirées de situations typiques de développement d'intégrations. Les chiffres sont arrondis, mais l'ordre de grandeur est réel.
Cas 1. Notifications de paiement d'une boutique en ligne
Une petite équipe développait une boutique sur un constructeur de sites et écrivait un gestionnaire de paiements en Python exécuté sur un ordinateur de bureau derrière un modem mobile. Dans les réglages du fournisseur de paiement, ils avaient indiqué l'adresse du proxy mobile, puisque « elle est publique ». Le fournisseur relançait la livraison selon un planning 1, 5, 30 minutes, 2 heures, puis désactivait l'abonnement. En une semaine, une quarantaine de commandes sont restées en statut « en attente de paiement » alors que les paiements étaient réellement passés, ce qui a nécessité un rapprochement manuel.
Solution : location d'un VPS minimal, mise en place d'un récepteur avec vérification de signature et file sur Redis, le gestionnaire restant local et vidant la file via une connexion sortante. En complément, un polling de rapprochement horaire sur la liste des paiements des dernières 24 heures avec curseur, qui rattrape les événements manqués pour n'importe quelle raison. Résultat : aucun écart entre le fournisseur et la comptabilité sur les trois mois suivants, avec un délai entre paiement et changement de statut de commande d'en moyenne 1,2 seconde.
Cas 2. Bot de support sur un portable avec modem
Un développeur écrivait un bot pour son équipe interne et voulait le lancer depuis un portable connecté via un modem mobile. La tentative d'enregistrer un webhook sur l'adresse du proxy a échoué comme prévu. Le passage au long polling via getUpdates avec un timeout de 50 secondes a résolu le problème en une demi-heure : la connexion est sortante, ni le modem ni le CGNAT ne la gênent. Consommation : environ 1 700 requêtes par jour en pleine inactivité, ce qui est négligeable pour cette API. Pour déboguer l'intégration avec un CRM externe qui ne sait faire que des webhooks, un tunnel SSH inverse vers un serveur loué avec domaine fixe a été mis en place, puis le récepteur a migré sur le serveur lui-même en production.
Cas 3. Surveillance des statuts sur une marketplace sans webhooks
Un opérateur de plusieurs boutiques sur une marketplace suivait les statuts de commandes via une API qui n'avait pas de webhooks. Un polling naïf toutes les 10 secondes pour chaque boutique donnait environ 50 000 requêtes par jour et se heurtait régulièrement au 429. Après refonte selon les principes de la sixième section (curseur updated_after, intervalle adaptatif de 15 secondes à 10 minutes, traitement du Retry-After, idempotence par identifiant de commande), la charge est tombée à environ 4 000 requêtes par jour, soit plus de 12 fois moins, avec une latence moyenne de détection des changements aux heures ouvrées qui est restée sous les 20 secondes. Les appels sortants vers l'API de la marketplace et vers l'API du service de livraison sont répartis sur des adresses de sortie Proxeon distinctes, pour que les quotas d'une intégration n'influent pas sur l'autre et pour qu'on voie immédiatement dans les logs, à l'adresse source, quelle boutique a initié la requête.
FAQ : questions fréquentes sur les proxys et la réception de webhooks
Si j'ai une IP proxy dédiée statique, puis-je recevoir des webhooks dessus ?
Non. La stabilité de l'adresse résout la question de la prévisibilité pour les requêtes sortantes et pour les listes d'autorisation côté API tierces. Mais il n'y a toujours aucun port en écoute avec votre code sur cette adresse : c'est le logiciel proxy qui y tourne, pas votre récepteur. Pour recevoir, il faut un serveur que vous contrôlez.
Pourquoi les services de vérification d'IP affichent-ils une adresse publique si elle n'est pas adressable de l'extérieur ?
Le service de vérification voit l'adresse source de la requête entrante qui lui parvient, c'est-à-dire l'adresse de la passerelle NAT de l'opérateur ou du nœud proxy. C'est l'adresse par laquelle le trafic sort, pas celle par laquelle on peut entrer chez vous. La visibilité d'une adresse de l'extérieur et la possibilité d'initier une connexion vers elle sont deux propriétés différentes.
Peut-on recevoir des webhooks via SOCKS5 avec la commande BIND ?
En pratique, non. La commande est décrite dans la spécification, mais sur les nœuds commerciaux elle n'est généralement pas implémentée pour des raisons de sécurité, et là où elle l'est, elle accepte une seule connexion entrante pendant un court laps de temps après une connexion sortante vers le même hôte. Inapplicable pour enregistrer une URL de webhook permanente avec TLS.
Quelle différence entre un tunnel inverse et une redirection de ports sur le routeur ?
La redirection de ports ne fonctionne que si votre équipement dispose d'une véritable adresse publique : le routeur accepte la connexion entrante et la transmet dans le réseau interne. Le tunnel inverse n'exige aucune adresse publique chez vous : votre machine initie elle-même une connexion sortante vers un serveur public, qui écoute en votre nom. Dans les réseaux mobiles avec CGNAT, la première méthode est par principe indisponible, la seconde fonctionne.
Un tunnel inverse est-il fiable en production ?
À certaines conditions : domaine fixe, reconnexion automatique, vérification de la vivacité de la connexion, supervision des coupures et mise en tampon côté public pendant l'indisponibilité. Sans ces conditions, le tunnel convient au développement, pas à l'exploitation. Pour les intégrations critiques, il est plus fiable de placer le récepteur directement sur le serveur public.
Le polling n'est-il vraiment pas moins bon que les webhooks en latence ?
Le long polling donne une latence comparable aux webhooks : l'événement arrive au moment où il se produit. Un polling adaptatif classique donne une latence allant de l'intervalle minimal aux heures actives à l'intervalle maximal en période creuse. Pour beaucoup de processus métier, une latence de 15 à 30 secondes est acceptable. Les webhooks, eux, dépendent de la joignabilité de la connexion entrante et exigent un mécanisme de rapprochement en cas de perte, si bien que dans les systèmes réels, le polling complète souvent les webhooks plutôt qu'il ne leur cède.
Faut-il un proxy si j'ai déjà un VPS avec adresse publique ?
Pour recevoir des webhooks, non. Pour les requêtes sortantes des gestionnaires, il est utile quand une API tierce est sensible à la région source, quand il faut isoler les quotas de différentes intégrations par adresse, ou quand on veut que les requêtes ressemblent au trafic d'un abonné mobile d'un opérateur donné. C'est une tâche distincte, qui se résout avec un outil distinct.
Comment vérifier que le fournisseur essaie vraiment de livrer le webhook ?
La plupart des fournisseurs tiennent un journal des livraisons avec les codes de réponse et les causes d'erreur. Consultez-le en premier : vous y verrez si le domaine se résout, si le TLS s'établit, quel code votre serveur a renvoyé et en combien de millisecondes. Pour un diagnostic local, lancez un serveur HTTP minimal qui journalise les en-têtes et le corps, et dirigez le tunnel vers lui.
Que faire si le fournisseur exige une réponse en 3 secondes alors que le traitement en prend 10 ?
Séparer la réception et le traitement. Le récepteur vérifie la signature, met l'événement en file et répond 200 en quelques dizaines de millisecondes. Un worker vide la file et traite l'événement aussi longtemps qu'il faut, en faisant les appels sortants vers les API tierces, au besoin via un proxy, avec des délais explicites et des réessais.
Conclusion : le bon modèle mental et les prochaines étapes
Si l'on devait réduire l'article à une seule idée, elle serait celle-ci : un proxy change d'où vous sortez sur le réseau, mais ne crée pas un endroit où l'on peut entrer chez vous. Le sens de la connexion est une propriété fondamentale, et aucune offre ne la renverse. Le proxy mobile Proxeon fait de vos requêtes sortantes le trafic d'un abonné d'un opérateur donné, et c'est précisément pour cela qu'il hérite de la non-adressabilité de l'abonné depuis l'extérieur : derrière le CGNAT, il n'y a pas de ports en écoute, et l'adresse change par nature du réseau.
La réception de webhooks se résout avec des outils d'une autre classe. Un serveur public avec domaine et TLS, c'est la base pour l'exploitation. Le tunnel inverse, c'est pour le développement et les cas où le code doit s'exécuter localement. La file d'événements et le long polling côté fournisseur, c'est la variante la plus élégante quand le fournisseur la propose. Le polling adaptatif avec curseur, requêtes conditionnelles et respect des quotas, c'est la solution de repli universelle qui, bien conçue, n'a rien à envier aux webhooks en valeur pratique.
Et le proxy revient dans le schéma là où il a sa place : dans les appels sortants depuis les gestionnaires, dans la vérification des événements par requête retour, dans l'isolation des quotas de différentes intégrations par adresse de sortie. Le récepteur écoute en direct, le sortant passe par le proxy — cette formule couvre la grande majorité des cas réels.
Ce qu'il faut faire après cette lecture
- Ouvrez les réglages de chacun de vos abonnements webhook et vérifiez où pointe l'URL : vers un serveur que vous contrôlez et qui écoute le port 443 avec un certificat valide.
- Assurez-vous que le récepteur répond vite et que le traitement est déporté dans une file ; vérifiez la présence de la vérification de signature et de la prise en compte des identifiants traités.
- Pour les intégrations sans webhooks, réécrivez le polling selon la check-list de la sixième section et mesurez l'évolution du nombre de requêtes et de la latence.
- Revoyez les appels sortants des gestionnaires : là où il faut une adresse régionale stable ou une isolation des quotas, branchez un proxy avec une session dédiée et des délais explicites.
- Ajoutez un polling de rapprochement comme filet de sécurité pour les webhooks critiques : une fois par heure, demandez les événements du dernier intervalle et comparez avec ceux traités.
Séparer les tâches en sortant et entrant, ce n'est pas du pédantisme, c'est le moyen d'arrêter de perdre des heures à déboguer ce qui ne peut pas fonctionner par définition, et de les consacrer à ce qui fonctionnera.
