Dlaczego proxy nie przyjmuje webhooków: kierunek połączenia i co stosować zamiast tego
Spis treści
- Wprowadzenie: dlaczego oczekiwanie „kupię proxy i przyjdzie do mnie webhook” się nie spełnia
- Podstawy: kierunek połączenia, czyli kto do kogo puka
- Głębokie zanurzenie: dlaczego klient proxy nie nasłuchuje portu i nie daje publicznego adresu
- Sieci komórkowe i wspólny adres: dlaczego adres abonencki nie jest adresowalny z zewnątrz
- Co naprawdę rozwiązuje problem przyjmowania webhooków: cztery sprawdzone podejścia
- Odpytywanie jako zamiennik webhooka: jak zaprojektować, aby nie trafić w limity
- Gdzie proxy jednak jest potrzebne obok webhooków: odpowiedzi wychodzące i wywołania zewnętrznych api
- Tabela „zadanie — odpowiednie rozwiązanie”
- Typowe błędy: czego nie należy robić
- Przypadki i wyniki: jak to wygląda w praktyce
- Faq: częste pytania o proxy i przyjmowanie webhooków
- Zakończenie: właściwy model i kolejne kroki
Wprowadzenie: dlaczego oczekiwanie „kupię proxy i przyjdzie do mnie webhook” się nie spełnia
Do wsparcia technicznego serwisów proxy regularnie trafia to samo pytanie, tylko różnie sformułowane. „Kupiłem proxy mobilne, wpisałem jego adres w ustawieniach integracji, a bramka płatnicza nie przysyła powiadomień”. „Wpisałem IP proxy jako URL webhooka w CRM, dostaję błąd połączenia”. „Mój skrypt przez proxy wszystko widzi, ale mnie przez to samo proxy nikt nie widzi, dlaczego?”. Sformułowania są różne, ale źródło jest jedno: błędny model myślowy tego, co właściwie robi proxy.
Oczekiwanie jest zrozumiałe. Proxy daje ci „inny adres IP”, a ten adres jest publiczny, pokazują go wszystkie serwisy sprawdzające. Logika podpowiada: jeśli mam publiczny adres, to znaczy, że można mnie pod nim znaleźć. Ale tak nie jest. Proxy, w tym mobilne proxy Proxeon, rozwiązuje problem zapytań wychodzących: twój kod inicjuje połączenie, przechodzi ono przez węzeł proxy, a zdalny serwer widzi adres tego węzła. Zadania odwrotnego, gdy to zdalny serwer sam inicjuje połączenie do ciebie, proxy nie rozwiązuje w ogóle. Nie dlatego, że w taryfie czegoś brakuje, ale dlatego, że jest ono skonstruowane zupełnie inaczej.
W tym materiale przeanalizujemy temat od podstaw. Dowiesz się, czym połączenie wychodzące różni się od przychodzącego na poziomie TCP, dlaczego klient proxy nie otwiera portu nasłuchującego i nie daje ci adresu, do którego można się zwrócić z zewnątrz, dlaczego adres abonencki w sieci komórkowej z natury nie jest adresowalny z zewnątrz, a przede wszystkim, co naprawdę stosować do przyjmowania webhooków: serwer z publicznym adresem, tunel odwrotny, kolejkę zdarzeń po stronie dostawcy albo dobrze zaprojektowane odpytywanie. Osobno przyjrzymy się, gdzie proxy w tym schemacie jednak ma swoje miejsce, i to miejsce istnieje. Przekierowanie portów i konfiguracja domowych routerów pozostają poza zakresem: to temat sąsiedni, jedynie zaznaczymy granicę jego zastosowania.
Materiał napisany jest dla deweloperów integracji, inżynierów DevOps i specjalistów technicznych, którzy budują automatyzację na bazie zewnętrznych API. Przykłady kodu podane są w Pythonie oraz w postaci poleceń powłoki, można je brać za podstawę.
Podstawy: kierunek połączenia, czyli kto do kogo puka
Zacznijmy od fundamentu, bez którego dalsze rozważania nie mają sensu. W sieciach TCP/IP każde połączenie ma inicjatora i nasłuchującego. Inicjator wysyła pierwszy pakiet z flagą SYN. Nasłuchujący wcześniej otworzył port, czeka na nim i odpowiada SYN-ACK. Dopiero po tym uścisku dłoni dane krążą w obie strony. Kluczowe słowo to „wcześniej”: nasłuchujący musi już znajdować się pod adresem, który jest routowany z internetu, i już trzymać port otwarty w momencie, gdy inicjator zechce zapukać.
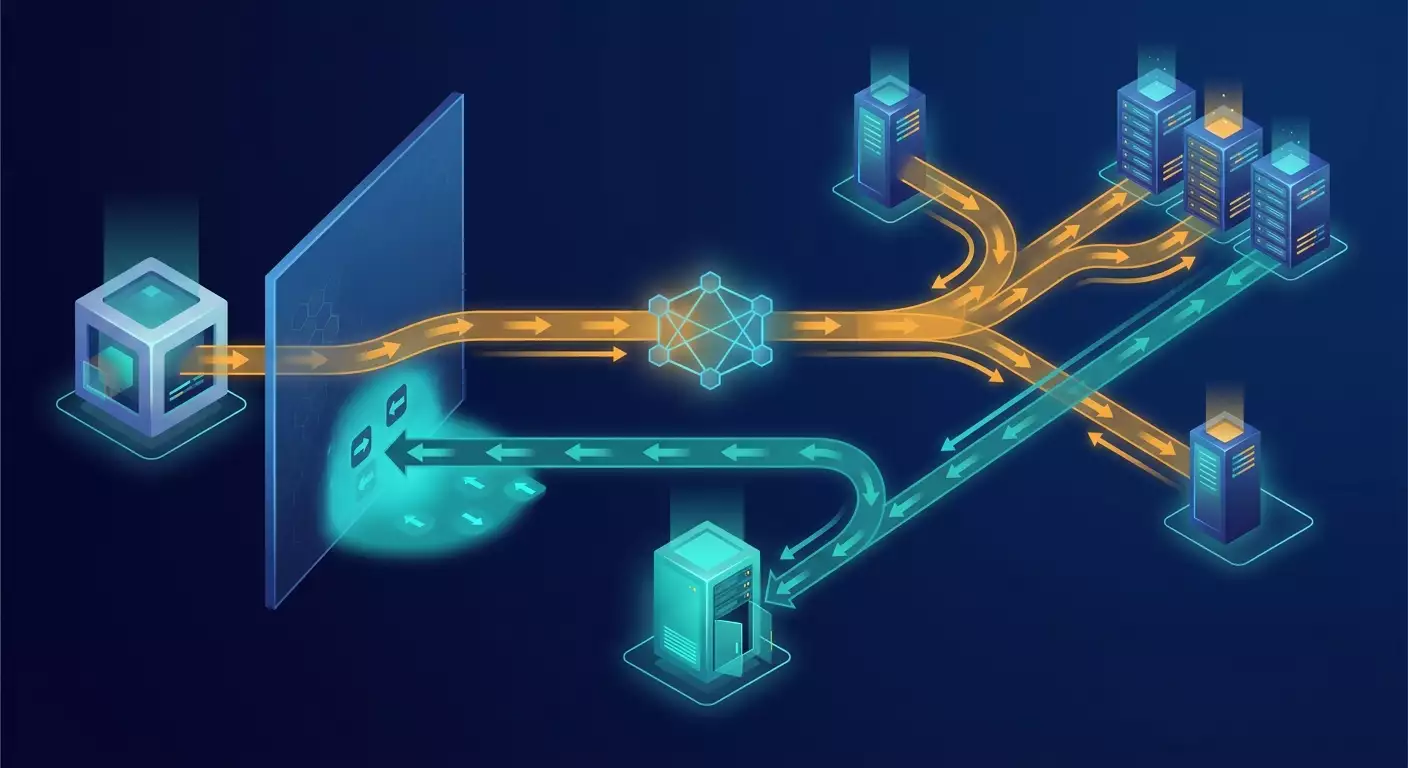
Schemat zapytania wychodzącego przez proxy
Wyobraźmy sobie schemat opisowo. Twój skrypt znajduje się w domu lub w biurze za NAT, albo w ogóle na laptopie z modemem mobilnym.
- Krok 1. Twój skrypt inicjuje połączenie z węzłem proxy: [twój kod] puka do [węzeł Proxeon].
- Krok 2. Węzeł proxy w swoim imieniu inicjuje połączenie z docelową witryną: [węzeł Proxeon] puka do [api.example.com].
- Krok 3. Docelowa witryna odpowiada po już otwartym połączeniu w kierunku odwrotnym, węzeł proxy przekazuje odpowiedź do ciebie po twoim otwartym połączeniu.
Zwróć uwagę: odpowiedź serwera nie jest połączeniem przychodzącym. To dane, które idą z powrotem kanałem otwartym przez ciebie. Drzwi otworzyłeś ty i ty je trzymasz, dopóki trwa wymiana. Gdy tylko zamknąłeś połączenie, drogi powrotnej nie ma. Nikt z zewnątrz nie może „kontynuować rozmowy” z własnej inicjatywy.
Schemat webhooka
Teraz webhook. Dostawca płatności, komunikator, CRM albo marketplace chce cię powiadomić o zdarzeniu: płatność przeszła, przyszła wiadomość, zmienił się status zamówienia.
- Krok 1. Dostawca bierze URL, który podałeś przy subskrypcji, rozwiązuje nazwę domeny na adres IP.
- Krok 2. Dostawca inicjuje połączenie z tym adresem na port 443: [serwer dostawcy] puka do [twój URL].
- Krok 3. Pod tym adresem i na tym porcie ktoś musi nasłuchiwać, przyjąć uścisk TLS z ważnym certyfikatem, przeanalizować żądanie HTTP i odpowiedzieć kodem 2xx.
Tu inicjatorem jest dostawca. Nasłuchującym musisz być ty. I tu pojawia się pytanie, na które cały artykuł daje rozbudowaną odpowiedź: jaki adres podasz dostawcy? Adres proxy? Ale węzeł proxy nie nasłuchuje dla ciebie. Adres twojego domowego łącza? Ale jest albo prywatny, albo za NAT operatora. Laptop z modemem? Nie ma w ogóle adresu routowalnego.
Analogia, która wszystko porządkuje
Proxy przypomina firmę kurierską dla listów wychodzących. Dajesz list kurierowi, on zanosi go adresatowi, a na kopercie widnieje adres zwrotny firmy kurierskiej, nie twój domowy. Adresat może włożyć odpowiedź do tej samej koperty, kurier wróci i ci ją odda, bo pamięta, od kogo przyjął list. Ale jeśli adresat po tygodniu zechce sam do ciebie napisać, napisze na adres firmy. Firma otrzyma list i nie będzie wiedziała, któremu z tysięcy klientów jest adresowany. Najprawdopodobniej w ogóle nie dotrze do skrzynki odbiorczej firmy, bo skrzynki przychodzącej tam nie ma. Aby otrzymywać listy, potrzebujesz własnego adresu pocztowego, a nie usługi dostarczania wychodzącego.
Głębokie zanurzenie: dlaczego klient proxy nie nasłuchuje portu i nie daje publicznego adresu
Zejdźmy na poziom protokołów. Istnieją dwie masowe rodziny proxy: proxy HTTP i proxy SOCKS. Zobaczmy, co każde z nich potrafi, i upewnijmy się, że połączenia przychodzące do twojej usługi nie znajdują się na tej liście ani na papierze, ani w praktyce.
Jak działa proxy HTTP
Proxy HTTP przyjmuje od klienta żądanie w postaci GET http://host/path lub, dla HTTPS, polecenie CONNECT host:443. W drugim przypadku proxy otwiera połączenie TCP z docelowym hostem i dalej po prostu przepompowuje bajty w obie strony, nie zaglądając do zaszyfrowanego ruchu. To wszystko. W protokole nie ma polecenia „zacznij nasłuchiwać portu dla mnie” ani „zarejestruj mi adres”. Klient jest zawsze inicjatorem, proxy zawsze pośrednikiem w kierunku „od klienta do świata”.
Oto minimalny przykład zapytania wychodzącego przez proxy w Pythonie. Działa, bo kierunek jest prawidłowy:
import requests

PROXY = 'http://user:pass@gate.proxeon.net:PORT'
proxies = {'http': PROXY, 'https': PROXY}

r = requests.get('https://api.example.com/v1/status', proxies=proxies, timeout=(5, 30))
print(r.status_code, r.json())
A oto próba skazana na porażkę. Załóżmy, że poznałeś zewnętrzne IP proxy, na przykład przez serwis sprawdzający adres, i postanowiłeś podać je jako URL webhooka:
curl -v --max-time 10 http://203.0.113.45/webhook
# wynik: connect() timed out lub Connection refused
Dlaczego tak? Na adresie 203.0.113.45 działa oprogramowanie proxy, które nasłuchuje swojego portu usługowego do przyjmowania poleceń od klientów, ale nie twojej ścieżki /webhook. Nawet gdyby na porcie 80 coś odpowiedziało, nie byłby to twój kod. Twój kod znajduje się na innej maszynie, za innym adresem, a serwer proxy nie ma pojęcia, że żądanie na ścieżkę /webhook należy przekierować właśnie do ciebie, a nie do jednego z setek innych klientów korzystających z tego samego adresu wyjściowego.
A co z SOCKS5 i poleceniem BIND?
Tu zaczyna się najciekawsza część, o której wie niewielu. W specyfikacji SOCKS5 rzeczywiście opisane są trzy polecenia: CONNECT, BIND i UDP ASSOCIATE. Polecenie BIND zostało pomyślane dokładnie dla scenariusza odwrotnego: klient prosi proxy o otwarcie portu nasłuchującego, a następnie o przyjęcie jednego połączenia przychodzącego i przekazanie go klientowi. To spadek po protokole FTP w trybie aktywnym, gdzie serwer musi łączyć się z klientem w celu transmisji danych.
Wydawałoby się, oto rozwiązanie. Ale są trzy powody, dla których w praktyce BIND ci nie pomoże:
- BIND przyjmuje dokładnie jedno połączenie przychodzące i to dopiero po tym, jak już nawiązałeś połączenie wychodzące z tym samym hostem. To nie „nasłuchuj portu stale dla kogokolwiek”, ale „otwórz drzwi dla jednego konkretnego rozmówcy, z którym już rozmawiam”.
- Zdecydowana większość komercyjnych serwerów proxy nie implementuje polecenia BIND albo wyłącza je ze względów bezpieczeństwa. Otwarty port nasłuchujący na wspólnym węźle z setkami klientów to wektor ataków i źródło nadużyć, więc po prostu go nie ma.
- Nawet tam, gdzie BIND istnieje, adres i port przydzielane są dynamicznie, na krótko, i w żaden sposób nie nadają się do zarejestrowania jako URL webhooka z certyfikatem TLS.
Podsumowując: teoretyczna możliwość w specyfikacji istnieje, praktycznego pożytku dla przyjmowania webhooków nie przynosi.
Co dostajesz razem z proxy, a czego nie
Sformułujmy to maksymalnie jasno. Kupując proxy, otrzymujesz:
- wychodzący adres IP, który widzą zdalne serwery przy twoich zapytaniach wychodzących;
- przynależność geograficzną i sieciową tego adresu, na przykład adres z puli operatora komórkowego konkretnego regionu;
- możliwość rotowania tego adresu albo, odwrotnie, utrzymania go stabilnym na czas sesji;
- rozdzielenie ruchu wychodzącego na różne kanały, jeśli prowadzisz kilka niezależnych integracji.
Nie otrzymujesz:
- portu nasłuchującego na adresie wyjściowym;
- adresu routowalnego, do którego strony trzecie mogą inicjować połączenie;
- nazwy domeny i certyfikatu TLS powiązanych z twoją usługą;
- gwarancji, że adres wyjściowy będzie ten sam za godzinę, jeśli taryfa przewiduje rotację.
Gdy ta tabela ułoży się w głowie, pytanie „dlaczego webhook nie przychodzi na proxy” przestaje być pytaniem. Staje się oczywistością.
Sieci komórkowe i wspólny adres: dlaczego adres abonencki nie jest adresowalny z zewnątrz
Osobnego omówienia wymagają sieci komórkowe, bo to właśnie mobilne proxy najczęściej stają się bohaterami historii o „nieprzychodzącym webhooku”. Tu do ograniczeń samego proxy dochodzi architektura sieci operatorskiej, a ona wzmacnia efekt wielokrotnie.
Deficyt adresów i CGNAT
Publicznych adresów IPv4 na świecie jest około czterech miliardów, a aktywnych połączeń mobilnych znacznie więcej. Żaden operator nie może przydzielić każdemu abonentowi własnego publicznego adresu. Dlatego operatorzy stosują Carrier-Grade NAT (CGNAT, translację adresów na poziomie operatorskim). Urządzenie abonenckie otrzymuje prywatny adres z specjalnie zarezerwowanego zakresu 100.64.0.0/10 lub ze znanego 10.0.0.0/8, a na granicy sieci stoi potężna bramka NAT, która transluje tysiące adresów abonenckich na jeden lub kilka publicznych.
Jak to wygląda z punktu widzenia adresowalności? Gdy twój modem wysyła pakiet na zewnątrz, bramka zapisuje w tabeli: „abonent 100.72.14.9, port 51234 → publiczny adres 203.0.113.45, port 40001”. Odpowiedź, która przyjdzie na 203.0.113.45:40001, bramka dopasuje do wpisu i zwróci ci ją. Ale wpisy tworzone są tylko przez ruch wychodzący i żyją sekundy lub minuty bezczynności. Jeśli ktoś z zewnątrz wyśle pakiet na 203.0.113.45 na port 443, w tabeli nie będzie ani jednego wpisu odpowiadającego temu pakietowi. Bramka go odrzuci. Nie „zablokuje”, ale właśnie nie będzie w stanie zrozumieć, do kogo z tysiąca abonentów jest adresowany.
Dlaczego jest to nieusuwalne po stronie abonenta
Z domowym dostawcą internetu bywa czasem inaczej: niektóre taryfy dają realny publiczny adres na router, i wtedy pojawia się temat sąsiedni — przekierowanie portów i konfiguracja routera. Świadomie go nie opisujemy, jedynie ustalmy granicę zastosowania: przekierowanie portów ma sens tylko tam, gdzie na twoim sprzęcie wisi prawdziwy routowalny adres. W sieci komórkowej takiego adresu abonent w zasadzie nie ma, nie ma czego przekierowywać i dokąd, konfiguracja sprzętu na ten fakt nie wpływa. Opcja publicznego adresu dla abonenta mobilnego u większości operatorów albo nie istnieje, albo jest świadczona jako osobna usługa korporacyjna, co już nie ma związku z proxy.
Dodatkowe warstwy: rotacja i filtrowanie
Do CGNAT dochodzą jeszcze dwa czynniki. Po pierwsze, publiczny adres, przez który wychodzi abonent, okresowo się zmienia: przy ponownym połączeniu, przy równoważeniu obciążenia, przy zmianie stacji bazowej. Mobilne proxy Proxeon wykorzystują tę właściwość jako pożyteczną: adres można rotować według harmonogramu lub na żądanie. Ale dla przyjmowania webhooków stabilność adresu jest krytyczna, a tu jej z definicji nie ma. Po drugie, operatorzy filtrują część ruchu przychodzącego na granicy sieci, bo urządzenia abonenckie nie są przeznaczone do bycia serwerami. Nawet tam, gdzie abonent otrzymuje publiczny adres IPv6, połączenia przychodzące do niego są często zamknięte przez zaporę operatora.
Wynik tego rozdziału warto wyróżnić: adres mobilnego proxy to tożsamość wychodząca, a nie adres usługi. To nie wada produktu, ale jego natura. Mobilne proxy kupuje się po to, aby zapytania wychodzące wyglądały jak ruch zwykłego abonenta konkretnego operatora i regionu. Właśnie dlatego, że ten ruch jest nieodróżnialny od abonenckiego, odziedziczył też abonencką nieadresowalność z zewnątrz.
Co naprawdę rozwiązuje problem przyjmowania webhooków: cztery sprawdzone podejścia
Przechodzimy od diagnozy do leczenia. Istnieją cztery dojrzałe sposoby przyjmowania zdarzeń od systemów zewnętrznych, gdy twój kod żyje za NAT, za modemem mobilnym albo w ogóle na laptopie. Każdy ma swoją niszę, swoją cenę i swoje ograniczenia. Omówmy je po kolei z przykładami.
Podejście 1. Serwer z publicznym adresem
Najbardziej bezpośredni i najpewniejszy sposób. Wynajmujesz serwer wirtualny u dostawcy hostingu, otrzymujesz wraz z nim publiczny adres IPv4, przypisujesz do niego nazwę domeny, wystawiasz certyfikat TLS i uruchamiasz odbiornik. Dostawcy webhooków w 2026 roku niemal powszechnie wymagają HTTPS z ważnym certyfikatem, więc ten krok jest obowiązkowy.
Plan krok po kroku:
- Wynajmij VPS o minimalnej konfiguracji w jurysdykcji odpowiadającej twoim wymaganiom dotyczącym przechowywania danych.
- Utwórz rekord A dla domeny w postaci
hooks.yourdomain.tld, wskazujący na adres serwera. - Zainstaluj odwrotny serwer proxy na poziomie web (nginx lub analog) i wystaw certyfikat przez klienta ACME.
- Uruchom aplikację-odbiornik na lokalnym porcie, zamkniętym przed światem, a serwer web skieruj na niego.
- Skonfiguruj weryfikację podpisu i kolejkę przetwarzania, aby szybko odpowiadać dostawcy.
Przykład odbiornika we Flasku z weryfikacją podpisu HMAC i szybką odpowiedzią. Ciężkie przetwarzanie odkładamy do kolejki, bo większość dostawców czeka na odpowiedź nie dłużej niż 5–10 sekund:
import hmac, hashlib, json, os
from flask import Flask, request, abort
from queue import Queue

app = Flask(__name__)
SECRET = os.environ['WEBHOOK_SECRET'].encode()
jobs = Queue()

def valid_signature(raw_body, header_sig):
expected = hmac.new(SECRET, raw_body, hashlib.sha256).hexdigest()
return hmac.compare_digest(expected, header_sig or '')

@app.post('/webhook/payments')
def payments():
raw = request.get_data()
if not valid_signature(raw, request.headers.get('X-Signature')):
abort(401)
event = json.loads(raw)
jobs.put(event) # przetwarzanie w tle, odpowiedź natychmiast
return '', 200
Zwróć uwagę na trzy szczegóły. Podpis weryfikowany jest po surowym ciele żądania, a nie po sparsowanym JSON-ie, inaczej każde przeformatowanie zepsuje porównanie. Porównanie wykonuje się przez compare_digest, aby nie wyciekał czas porównania. Odpowiedź 200 zwracana jest przed przetwarzaniem, a samo zdarzenie trafia do kolejki. Jeśli dostawca nie otrzyma 2xx w wyznaczonym czasie, uzna dostarczenie za nieudane i zacznie powtórzenia, a ty dostaniesz duplikaty.
Podejście 2. Tunel odwrotny
Jeśli kod ma być wykonywany właśnie na twojej lokalnej maszynie, a nie na serwerze, użyj tunelu odwrotnego. Idea jest elegancka i w pełni zgodna z tym, co omówiliśmy powyżej: twoja maszyna sama inicjuje połączenie wychodzące do publicznego serwera, a ten zaczyna nasłuchiwać portu w twoim imieniu i zawija połączenia przychodzące w już otwarty kanał. Kierunek inicjacji jest wychodzący, więc NAT i CGNAT mu nie przeszkadzają. Publiczny nasłuchujący znajduje się na serwerze, więc dostawca webhooków może do niego dotrzeć.
Najprostsza realizacja za pomocą SSH. Na publicznym serwerze w konfiguracji sshd musi być włączona opcja GatewayPorts albo użyty lokalny serwer web jako front. Z lokalnej maszyny:
# lokalny odbiornik nasłuchuje 127.0.0.1:8080
# prosimy serwer o nasłuchiwanie 127.0.0.1:9000 i zawijanie ruchu do nas
ssh -N -R 9000:127.0.0.1:8080 tunnel@hooks.yourdomain.tld

# na serwerze nginx proxy'uje https://hooks.yourdomain.tld/webhook -> 127.0.0.1:9000
Do zastosowań przemysłowych pojedynczy proces ssh nie jest wystarczająco niezawodny: połączenie może się zerwać. Użyj nakładki z automatycznym ponownym łączeniem (autossh lub podobny supervisor) i włącz ServerAliveInterval, aby przerwy wykrywane były w kilka sekund. Istnieją też wyspecjalizowane serwisy tunelowe i rozwiązania do samodzielnego wdrożenia oparte na tej samej zasadzie, z automatycznym wystawianiem certyfikatów i panelem web. Zasada wszędzie jest jedna: lokalny agent utrzymuje połączenie wychodzące, strona publiczna przyjmuje webhooki.
Ograniczenia podejścia warto pamiętać. Dopóki tunel jest zerwany, webhooki giną albo trafiają do powtórzeń dostawcy. Tymczasowe adresy niektórych serwisów tunelowych zmieniają się przy restarcie, co dla produkcji jest niedopuszczalne: potrzebna jest przypięta domena. I tunel dodaje opóźnienie i punkt awarii. Do programowania i debugowania to narzędzie idealne, do eksploatacji nadaje się tylko w połączeniu z monitoringiem.
Podejście 3. Kolejka zdarzeń po stronie dostawcy
Wiele dojrzałych API oferuje alternatywę dla modelu push: zdarzenia trafiają do dziennika lub kolejki po stronie dostawcy, a ty odbierasz je, kiedy ci wygodnie. To zmienia kierunek połączenia na wychodzący dla ciebie, i cały problem adresowalności znika.
Kanoniczny przykład — Bot API jednego z komunikatorów z metodą getUpdates: serwer przechowuje nieprzeczytane aktualizacje do doby, a klient okresowo je pobiera, przekazując offset ostatniej przetworzonej. Podobne mechanizmy są u systemów płatniczych w postaci listy zdarzeń z kursorem, u marketplace'ów w postaci kolejki zmian zamówień, u dostawców chmury w postaci zarządzanych kolejek komunikatów, do których można skierować webhooki i odbierać je klientem.
import requests, time

TOKEN = 'your-bot-token'
BASE = f'https://api.messenger.example/bot{TOKEN}'
offset = 0

while True:
resp = requests.get(f'{BASE}/getUpdates',
params={'offset': offset, 'timeout': 50},
timeout=60)
for upd in resp.json().get('result', []):
handle(upd)
offset = upd['update_id'] + 1
Parametr timeout=50 włącza tu long polling: serwer trzyma połączenie otwarte do pojawienia się zdarzenia lub do upływu timeoutu, i otrzymujesz niemal natychmiastowe dostarczenie bez częstych pustych zapytań. To połączenie wychodzące, spokojnie działa przez NAT, przez modem mobilny, a jeśli trzeba, przez proxy.
Jeśli dostawca nie oferuje wbudowanej kolejki, można zbudować ją samodzielnie z pierwszego podejścia: minimalny odbiornik na VPS przyjmuje webhooki i składa je do kolejki komunikatów, a twoja lokalna maszyna kolejkę odbiera. Powstaje hybryda łącząca niezawodność publicznego adresu z elastycznością lokalnego wykonywania.
Podejście 4. Odpytywanie zamiast subskrypcji
Gdy dostawca nie oferuje ani webhooków, ani kolejki zdarzeń, pozostaje klasyczne odpytywanie stanu: okresowo odpytujesz zasób i porównujesz z poprzednim stanem. To podejście najbardziej uniwersalne, bo nie wymaga od dostawcy niczego poza zwykłym API odczytu. Ale też najbardziej wymagające pod względem projektowania: naiwna pętla ze stałym interwałem szybko trafia w limity zapytań, marnuje budżet na puste odpowiedzi, a przy tym spóźnia się ze zdarzeniami. Następny rozdział poświęcony jest w całości temu, jak tego uniknąć.
Narzędzia, które się przydadzą
- Serwer web na poziomie frontu (nginx lub odpowiednik) do terminacji TLS i routingu na aplikację.
- Klient ACME do automatycznego wystawiania i odnawiania certyfikatów.
- Kolejka komunikatów (Redis Streams, RabbitMQ albo zarządzana kolejka chmury) do buforowania zdarzeń między przyjęciem a przetworzeniem.
- Supervisor tunelu z automatycznym ponownym łączeniem dla tuneli odwrotnych.
- Lokalny inspektor żądań do debugowania: dowolny minimalny serwer HTTP logujący nagłówki i ciało pomoże zobaczyć, co dokładnie wysyła dostawca.
- Proxy Proxeon do wychodzących wywołań zewnętrznych API z handlerów, o czym szczegółowo poniżej.
Odpytywanie jako zamiennik webhooka: jak zaprojektować, aby nie trafić w limity
Odpytywanie jest krytykowane za marnotrawność i często słusznie. Ale marnotrawny nie jest sam odpytywanie jako taki, a jego zła implementacja. Poprawnie zaprojektowany poller pod względem obciążenia API jest porównywalny z webhookami, a przy tym niezawodniejszy, bo nie zależy od dostarczalności połączeń przychodzących. Omówmy zasady.
Zasada 1. Kursor zamiast pełnego wyboru
Nigdy nie odpytuj o „wszystkie zamówienia” i nie szukaj zmian po swojej stronie. Używaj parametrów w postaci since, updated_after, cursor albo page_token, które są niemal w każdym nowoczesnym API. Zapisuj ostatni kursor trwale, aby restart procesu nie powodował ponownego pobrania historii. Odpowiedź po kursorze jest mała, przetwarzana szybko i nie tworzy obciążenia u dostawcy.
Zasada 2. Zapytania warunkowe
Jeśli zasób obsługuje nagłówki ETag i If-None-Match albo Last-Modified i If-Modified-Since, używaj ich. Odpowiedź 304 Not Modified nie zawiera ciała i często nie liczy się do limitu albo liczy się po obniżonej stawce. To darmowy sposób na kilkukrotne zmniejszenie ruchu.
Zasada 3. Adaptacyjny interwał z jitterem
Stały interwał jest zły podwójnie: w cichych godzinach marnuje zapytania, w szczytowych się spóźnia. Schemat adaptacyjny jest prosty: po pustej odpowiedzi zwiększaj interwał (np. mnóż przez 1,5 do pułapu), po niepustej zeruj do minimum. Dodawaj losowy rozrzut 10–20 procent, aby kilka twoich instancji nie uderzało w API synchronicznie.
Zasada 4. Szacunek dla sygnałów serwera
Nagłówki Retry-After, X-RateLimit-Remaining i X-RateLimit-Reset istnieją nie dla ozdoby. Otrzymawszy 429, czekaj dokładnie tyle, ile powiedziano. Widząc, że pozostały limit spada poniżej progu, zwalniaj zawczasu. To nie tylko uprzejmość, ale i ochrona przed czasowymi blokadami klucza.
Zasada 5. Idempotentność przetwarzania
Odpytywanie z natury może zwrócić to samo zdarzenie dwukrotnie: na granicy kursora, po awarii, przy nakładaniu się okien. Każde zdarzenie musi mieć unikalny identyfikator, a handler — tabelę już przetworzonych identyfikatorów z rozsądnym okresem przechowywania. Ta sama zasada ratuje też przed duplikatami webhooków przy powtórnych dostarczeniach.
Gotowy szkielet adaptacyjnego pollera
import random, time, requests

MIN_INTERVAL, MAX_INTERVAL = 5, 300
interval = MIN_INTERVAL
cursor = load_cursor() # z bazy lub pliku
etag = None
seen = SeenStore(ttl_hours=48) # magazyn przetworzonych id

while True:
headers = {'If-None-Match': etag} if etag else {}
r = requests.get('https://api.example.com/v1/events',
 params={'cursor': cursor, 'limit': 100},
 headers=headers, timeout=(5, 30))

if r.status_code == 429:
time.sleep(int(r.headers.get('Retry-After', 60)))
continue
if r.status_code == 304:
interval = min(interval * 1.5, MAX_INTERVAL)
elif r.ok:
etag = r.headers.get('ETag')
events = r.json()['data']
for ev in events:
if not seen.contains(ev['id']):
handle(ev)
seen.add(ev['id'])
if events:
cursor = r.json()['next_cursor']
save_cursor(cursor)
interval = MIN_INTERVAL
else:
interval = min(interval * 1.5, MAX_INTERVAL)

remaining = int(r.headers.get('X-RateLimit-Remaining', 1000))
if remaining < 50:
interval = max(interval, 60)

time.sleep(interval * random.uniform(0.9, 1.2))
Lista kontrolna projektowania odpytywania
- Kursor lub znacznik czasu zapisywane trwale i przeżywają restart.
- Używane są zapytania warunkowe, jeśli API je obsługuje.
- Interwał jest adaptacyjny, z pułapem i jitterem.
- Kod 429 i nagłówek Retry-After obsługiwane jawnie.
- Każde zdarzenie przetwarzane idempotentnie po unikalnym identyfikatorze.
- Timeouty połączenia i odczytu ustawione jawnie i osobno.
- Metryki: częstotliwość zapytań, udział pustych odpowiedzi, opóźnienie od zdarzenia do przetworzenia.
- Jeśli dostawca obsługuje long polling, jest on włączony, a zwykłe odpytywanie wyłączone.
Przy takim projekcie poller z minimalnym interwałem 5 sekund w ciszy wychodzi na interwał 5 minut i wykonuje około 300 zapytań na dobę na zasób. To kilkadziesiąt razy mniej niż naiwna pętla raz na 10 sekund, która wykonuje 8640 zapytań na dobę przy tym samym średnim opóźnieniu dostarczenia w godzinach aktywnych.
Gdzie proxy jednak jest potrzebne obok webhooków: odpowiedzi wychodzące i wywołania zewnętrznych API
Byłoby nie w porządku zakończyć na myśli „proxy nie ma związku z webhookami”. Ma, i to bardzo konkretny, tylko po drugiej stronie schematu. Po przyjęciu zdarzenia twój handler niemal zawsze wykonuje zapytania wychodzące: potwierdza operację, dopytuje o szczegóły zamówienia, wysyła dane do innego systemu, powiadamia użytkownika. Wszystkie te zapytania są wychodzące, i tu właśnie proxy jest na swoim miejscu.
Scenariusz 1. Weryfikacja zdarzenia zapytaniem zwrotnym
Dobra praktyka bezpieczeństwa: nie ufać ślepo ciału webhooka, ale po sprawdzeniu podpisu dopytać obiekt u dostawcy po jego identyfikatorze. To zapytanie idzie z twojego serwera do API dostawcy. Jeśli dostawca ogranicza dostęp regionalnie albo prowadzi analizę behawioralną źródła zapytań, stabilny adres wyjściowy z właściwego regionu przez Proxeon czyni obraz ruchu przewidywalnym.
Scenariusz 2. Wywołania zewnętrznych API z handlera
Handler webhooka marketplace'u może odwoływać się do API firmy kurierskiej, serwisu weryfikacji kontrahentów, API kartograficznego. Każde z nich ma swoje limity na adres IP. Rozłożenie integracji na różne adresy wyjściowe izoluje je od siebie: wyczerpanie limitu jednej integracji nie paraliżuje pozostałych.
Scenariusz 3. Rozdzielenie tożsamości ruchu wychodzącego
Gdy jeden serwer obsługuje kilku niezależnych klientów lub projektów, warto, aby ich ruch wychodzący do zewnętrznych API szedł z różnych adresów. Upraszcza to diagnostykę (po adresie widać, czyje jest zapytanie) i zmniejsza ryzyko, że problemy jednego projektu dotkną inne.
Przykład: odbiornik bezpośrednio, wychodzące przez proxy
Główna zasada: odbiornik webhooków nasłuchuje bezpośrednio na publicznym adresie, a proxy służy wyłącznie do wywołań wychodzących. Nie próbuj „zawijać” odbiornika w proxy, to bezsensowne z wszystkich powodów omówionych powyżej.
import requests
from flask import Flask, request

app = Flask(__name__)

OUT_PROXY = 'http://user:pass@gate.proxeon.net:PORT'
outbound = requests.Session()
outbound.proxies = {'http': OUT_PROXY, 'https': OUT_PROXY}

@app.post('/webhook/orders')
def orders():
event = request.get_json()
# przyjęcie idzie bezpośrednio, bez proxy
order_id = event['order_id']
# weryfikacja wychodząca i wywołania zewnętrznych API - przez proxy
full = outbound.get(f'https://api.marketplace.example/orders/{order_id}',
timeout=(5, 20)).json()
outbound.post('https://api.delivery.example/shipments',
 json={'order': full}, timeout=(5, 20))
return '', 200
Kilka praktycznych uwag. Trzymaj osobny Session dla wywołań wychodzących, aby ustawienia proxy nie przeciekały do innych części aplikacji. Ustawiaj timeouty jawnie: przez proxy droga jest dłuższa, a zawieszone wywołanie wychodzące nie powinno opóźniać odpowiedzi dostawcy webhooka. W idealnym przypadku wywołania wychodzące rób nie w handlerze żądania HTTP, ale w wątku roboczym, który odbiera z kolejki. A jeśli dostawca zewnętrznego API wymaga wpisania twojego adresu na listę dozwolonych, użyj taryfy ze statycznym adresem wyjściowym, a nie rotowanym.
Tabela „zadanie — odpowiednie rozwiązanie”
Zbierzmy wszystko w jeden spis. Dla każdego typowego zadania wskazano, czy rozwiązuje je proxy, i czego użyć zamiast niego lub razem z nim.
- Zadanie: wykonywać zapytania wychodzące do zewnętrznych API z właściwego regionu lub operatora. Rozwiązanie: proxy Proxeon, taryfa statyczna lub rotowana w zależności od wymagań. Rola proxy: główna.
- Zadanie: przyjmować webhooki od bramki płatniczej w produkcji. Rozwiązanie: VPS z publicznym adresem, domena, TLS, odbiornik z weryfikacją podpisu i kolejką. Rola proxy: tylko dla wywołań wychodzących z handlera.
- Zadanie: zdebugować przyjmowanie webhooków na lokalnej maszynie dewelopera. Rozwiązanie: tunel odwrotny do publicznego serwera z przypiętą domeną. Rola proxy: brak.
- Zadanie: odbierać zdarzenia od komunikatora lub API z kolejką, kod wykonywany w domu albo za modemem mobilnym. Rozwiązanie: long polling metod w rodzaju getUpdates, odbieranie kolejki dostawcy. Rola proxy: opcjonalnie dla zapytań wychodzących.
- Zadanie: śledzić zmiany w API bez webhooków i kolejek. Rozwiązanie: adaptacyjne odpytywanie z kursorem, zapytaniami warunkowymi i szacunkiem dla limitów. Rola proxy: rozłożenie obciążenia na adresy wyjściowe w ramach limitów dostawcy.
- Zadanie: przyjmować webhooki na komputerze podłączonym przez modem mobilny. Rozwiązanie: niemożliwe bezpośrednio z powodu CGNAT; użyj tunelu odwrotnego albo kolejki. Rola proxy: brak.
- Zadanie: kilka integracji na jednym serwerze nie może sobie przeszkadzać w limitach zewnętrznych API. Rozwiązanie: osobne adresy wyjściowe Proxeon na integrację plus osobne kolejki. Rola proxy: główna dla części wychodzącej.
- Zadanie: zewnętrzne API wymaga wpisania adresu na listę dozwolonych. Rozwiązanie: statyczny adres wyjściowy; dla przyjmowania webhooków — publiczny adres twojego serwera. Rola proxy: taryfa statyczna dla części wychodzącej.
- Zadanie: uzyskać publiczny adres na domowym routerze. Rozwiązanie: temat sąsiedni, zależy od domowego dostawcy; stosowalny tylko przy realnym publicznym adresie na sprzęcie. Rola proxy: brak.
Typowe błędy: czego nie należy robić
Zbierzmy najczęściej spotykane pułapki. Niektóre kosztują godziny debugowania, inne — utracone płatności.
Błąd 1. Wskazywanie adresu proxy jako URL webhooka
Omówione szczegółowo powyżej, ale powtórzmy: na adresie wyjściowym proxy nie ma twojego nasłuchującego. Dostawca dostanie timeout albo odmowę połączenia, po kilku niepowodzeniach wyłączy subskrypcję. Niektórzy dostawcy przy powtarzających się błędach blokują URL na długi czas.
Błąd 2. Wskazywanie adresu lokalnego lub prywatnego
URL w postaci http://192.168.1.10:8080/hook albo http://localhost/hook jest routowany tylko w twojej sieci. Dostawca fizycznie nie może do niego dotrzeć. Wielu dostawców od razu odrzuca takie URL-e przy rejestracji subskrypcji, ale nie wszyscy.
Błąd 3. Samopodpisany certyfikat albo zwykły HTTP
Dostawcy webhooków sprawdzają certyfikat. Samopodpisany albo wygasły certyfikat prowadzi do cichego odrzucenia dostarczenia. Zwykłego HTTP bez TLS większość dostawców nie dopuszcza w ogóle.
Błąd 4. Długie przetwarzanie wewnątrz handlera HTTP
Jeśli handler ciągnie dane z trzech zewnętrznych API i pisze do bazy przed odpowiedzią dostawcy, łatwo przekracza timeout oczekiwania. Dostawca uznaje dostarczenie za nieudane i powtarza. Przetwarzasz jedno zdarzenie kilka razy. Odpowiedź powinna wychodzić w setki milisekund, przetwarzanie — do kolejki.
Błąd 5. Brak idempotentności
Powtórne dostarczenia to norma, nie wyjątek. Bez uwzględnienia przetworzonych identyfikatorów dwa razy utworzysz zamówienie, dwa razy wyślesz powiadomienie albo dwa razy przeprowadzisz obciążenie w systemie księgowym.
Błąd 6. Ślepe zaufanie ciału webhooka
Publiczny URL jest dostępny dla wszystkich. Bez weryfikacji podpisu każdy może wysłać ci fałszywe zdarzenie „płatność przeszła”. Sprawdzaj HMAC, a dla operacji krytycznych dopytuj obiekt u dostawcy.
Błąd 7. Tymczasowy adres tunelu w produkcji
Losowo wygenerowana domena serwisu tunelowego zmienia się przy restarcie. Subskrypcja dostawcy pozostaje przywiązana do starego URL-a. Zdarzenia giną, dopóki ktoś nie zauważy. W eksploatacji tunel jest dopuszczalny tylko z przypiętą domeną i monitoringiem.
Błąd 8. Odpytywanie ze stałym krótkim interwałem
Raz na sekundę bez kursora i zapytań warunkowych to prosta droga do 429 i czasowej blokady klucza. Co gorsza, przy blokadzie przestajesz otrzymywać cokolwiek, a opóźnienie dostarczenia staje się nieskończone.
Błąd 9. Pomijanie timeoutów przy wywołaniach wychodzących przez proxy
Proxy dodaje węzeł pośredniczący. Bez jawnych timeoutów zawieszone wywołanie wychodzące trzyma wątek roboczy, a jeśli wykonane jest wewnątrz handlera HTTP, przerywa też odpowiedź dla dostawcy. Zawsze ustawiaj timeout połączenia i odczytu osobno.
Błąd 10. Oczekiwanie, że polecenie BIND w SOCKS5 zrobi z ciebie serwer
Spotyka się u tych, którzy przeczytali specyfikację. Na węzłach komercyjnych polecenie z reguły nie jest zaimplementowane, a tam, gdzie jest, daje pojedyncze połączenie na krótki czas. Do webhooków się nie nadaje.
Przypadki i wyniki: jak to wygląda w praktyce
Trzy historie zebrane z typowych sytuacji w rozwoju integracji. Liczby zaokrąglone, ale rząd wielkości jest realny.
Przypadek 1. Powiadomienia płatnicze sklepu internetowego
Niewielki zespół rozwijał sklep na kreatorze stron i pisał handler płatności w Pythonie, który wykonywał się na biurowym komputerze za modemem mobilnym. W ustawieniach dostawcy płatności wpisano adres mobilnego proxy, bo „przecież jest publiczny”. Dostawca powtarzał dostarczenie według harmonogramu 1, 5, 30 minut, 2 godziny, potem wyłączył subskrypcję. W ciągu tygodnia nazbierało się około 40 zamówień w statusie „oczekuje na płatność” przy faktycznie dokonanych płatnościach, co wymagało ręcznego uzgodnienia.
Rozwiązanie: wynajęto minimalny VPS, postawiono odbiornik z weryfikacją podpisu i kolejką na Redisie, handler pozostał lokalny i odbiera kolejkę przez połączenie wychodzące. Dodatkowo raz na godzinę uruchamiane jest odpytywanie kontrolne listy płatności z ostatniej doby z kursorem, które łapie zdarzenia pominięte z powodu wszelkich awarii. Wynik: rozbieżności między dostawcą a księgowością w ciągu następnych trzech miesięcy nie odnotowano, czas od płatności do zmiany statusu zamówienia wyniósł średnio 1,2 sekundy.
Przypadek 2. Bot wsparcia na laptopie z modemem
Deweloper pisał bota dla zespołu wewnętrznego i chciał uruchamiać go z laptopa podłączonego przez modem mobilny. Próba zarejestrowania webhooka na adres proxy oczywiście się nie powiodła. Przejście na long polling przez getUpdates z timeoutem 50 sekund rozwiązało zadanie w pół godziny: połączenie wychodzące, ani modem, ani CGNAT mu nie przeszkadzają. Zużycie zapytań — około 1700 na dobę w pełnym bezczynie, co dla tego API jest nieistotne. Do debugowania integracji z zewnętrznym CRM, który obsługuje tylko webhooki, postawiono tunel odwrotny SSH do wynajętego serwera z przypiętą domeną, a na produkcji odbiornik przeniósł się na sam serwer.
Przypadek 3. Monitorowanie statusów na marketplace bez webhooków
Operator kilku sklepów na marketplace śledził statusy zamówień przez API, które nie miało webhooków. Naiwne odpytywanie co 10 sekund dla każdego sklepu dawało około 50 tysięcy zapytań na dobę i regularnie trafiało w 429. Po przeprojektowaniu według zasad z szóstego rozdziału (kursor updated_after, adaptacyjny interwał od 15 sekund do 10 minut, obsługa Retry-After, idempotentność po identyfikatorze zamówienia) obciążenie spadło do około 4 tysięcy zapytań na dobę, czyli ponad dwunastokrotnie, a średnie opóźnienie wykrycia zmiany w godzinach pracy pozostało w granicach 20 sekund. Wywołania wychodzące do API marketplace i do API firmy kurierskiej rozdzielono na osobne adresy wyjściowe Proxeon, aby limity jednej integracji nie wpływały na drugą i aby po adresie źródła w logach od razu było widać, który sklep zainicjował zapytanie.
FAQ: częste pytania o proxy i przyjmowanie webhooków
Jeśli mam statyczny dedykowany adres IP proxy, czy mogę na niego przyjmować webhooki?
Nie. Statyczność adresu rozwiązuje kwestię przewidywalności dla zapytań wychodzących i dla list dozwolonych adresów po stronie zewnętrznych API. Ale portu nasłuchującego z twoim kodem na tym adresie nadal nie ma: tam działa oprogramowanie proxy, a nie twój odbiornik. Do przyjmowania potrzebny jest serwer, który kontrolujesz.
Dlaczego serwisy sprawdzające IP pokazują publiczny adres, jeśli nie jest adresowalny z zewnątrz?
Serwis sprawdzający widzi adres źródłowy zapytania przychodzącego do niego, czyli adres bramki NAT operatora albo węzła proxy. To adres, z którego ruch wychodzi, a nie adres, na który można do ciebie wejść. Widoczność adresu z zewnątrz i możliwość inicjowania do niego połączenia to różne właściwości.
Czy można przyjmować webhooki przez SOCKS5 z poleceniem BIND?
W praktyce nie. Polecenie jest opisane w specyfikacji, ale na węzłach komercyjnych zwykle nie jest zaimplementowane ze względów bezpieczeństwa, a gdzie jest, przyjmuje jedno połączenie przychodzące na krótki czas po połączeniu wychodzącym z tym samym hostem. Do zarejestrowania stałego URL-a webhooka z TLS jest to nieprzydatne.
Czym tunel odwrotny różni się od przekierowania portów na routerze?
Przekierowanie portów działa tylko wtedy, gdy na twoim sprzęcie jest realny publiczny adres: router przyjmuje połączenie przychodzące i przekazuje je do sieci wewnętrznej. Tunel odwrotny nie wymaga u ciebie publicznego adresu w ogóle: twoja maszyna sama inicjuje połączenie wychodzące do publicznego serwera, a ten nasłuchuje w twoim imieniu. W sieciach komórkowych z CGNAT pierwszy sposób jest w zasadzie niedostępny, drugi działa.
Czy tunel odwrotny jest niezawodny dla produkcji?
Pod warunkami: przypięta domena, automatyczne ponowne łączenie, sprawdzanie żywotności połączenia, monitoring przerw i buforowanie po stronie publicznej na czas niedostępności. Bez tych warunków tunel nadaje się do programowania, ale nie do eksploatacji. Dla krytycznych integracji niezawodniej jest umieścić odbiornik bezpośrednio na publicznym serwerze.
Czy odpytywanie na pewno nie jest gorsze od webhooków pod względem opóźnienia?
Long polling daje opóźnienie porównywalne z webhookami: zdarzenie przychodzi w momencie pojawienia się. Zwykłe adaptacyjne odpytywanie daje opóźnienie od minimalnego interwału w godzinach aktywnych do maksymalnego w ciszy. Dla wielu procesów biznesowych opóźnienie 15–30 sekund jest akceptowalne. Webhooki natomiast zależą od dostarczalności połączenia przychodzącego i wymagają mechanizmu uzgodnienia na wypadek strat, więc w realnych systemach odpytywanie często uzupełnia webhooki, a nie im ustępuje.
Czy potrzebne jest proxy, jeśli mam już VPS z publicznym adresem?
Do przyjmowania webhooków nie. Do zapytań wychodzących z handlerów jest przydatne, gdy zewnętrzne API jest wrażliwe na region źródła, gdy trzeba izolować limity różnych integracji po adresach albo gdy wymagane jest, aby zapytania wyglądały jak ruch abonenta mobilnego konkretnego operatora. To osobne zadanie i rozwiązuje się je osobnym narzędziem.
Jak upewnić się, że dostawca w ogóle próbuje dostarczyć webhook?
Większość dostawców prowadzi dziennik dostarczeń z kodami odpowiedzi i przyczynami błędów. Zajrzyj do niego w pierwszej kolejności: będzie tam widać, czy domena się rozwiązuje, czy TLS się nawiązuje, jaki kod zwrócił twój serwer i w jakim czasie. Do lokalnej diagnostyki uruchom minimalny serwer HTTP logujący nagłówki i ciało i skieruj na niego tunel.
Co zrobić, jeśli dostawca wymaga odpowiedzi w 3 sekundy, a przetwarzanie zajmuje 10?
Rozdzielić przyjęcie i przetwarzanie. Odbiornik sprawdza podpis, wkłada zdarzenie do kolejki i odpowiada 200 w dziesiątkach milisekund. Wątek roboczy odbiera z kolejki i przetwarza zdarzenie tyle, ile trzeba, wykonując wywołania wychodzące do zewnętrznych API, w razie potrzeby przez proxy, z jawnymi timeoutami i powtórzeniami.
Zakończenie: właściwy model i kolejne kroki
Jeśli sprowadzić artykuł do jednej myśli, brzmi ona tak: proxy zmienia to, skąd wychodzisz do sieci, ale nie tworzy miejsca, do którego można do ciebie wejść. Kierunek połączenia to właściwość fundamentalna i żadna taryfa jej nie odwróci. Mobilne proxy Proxeon czyni twoje zapytania wychodzące ruchem abonenta konkretnego operatora, i właśnie dlatego dziedziczy ono abonencką nieadresowalność z zewnątrz: za CGNAT nie ma portów nasłuchujących, a adres zmienia się z natury sieci.
Przyjmowanie webhooków rozwiązuje się narzędziami innej klasy. Publiczny serwer z domeną i TLS — wariant podstawowy dla eksploatacji. Tunel odwrotny — dla programowania i przypadków, gdy kod ma wykonywać się lokalnie. Kolejka zdarzeń i long polling po stronie dostawcy — najelegancki wariant, gdy dostawca go oferuje. Adaptacyjne odpytywanie z kursorem, zapytaniami warunkowymi i szacunkiem dla limitów — uniwersalna droga zapasowa, która przy dobrym projekcie nie ustępuje webhookom pod względem praktycznej wartości.
A proxy wraca do schematu tam, gdzie jest jego miejsce: w wywołaniach wychodzących z handlerów, w weryfikacji zdarzeń zapytaniem zwrotnym, w izolacji limitów różnych integracji po adresach wyjściowych. Odbiornik nasłuchuje bezpośrednio, wychodzące idą przez proxy — ta formuła zamyka zdecydowaną większość realnych zadań.
Co zrobić po przeczytaniu
- Otwórz ustawienia każdej swojej subskrypcji webhooków i sprawdź, dokąd wskazuje URL: na serwer, który kontrolujesz i który nasłuchuje portu 443 z ważnym certyfikatem.
- Upewnij się, że odbiornik odpowiada szybko, a przetwarzanie jest wyniesione do kolejki; sprawdź obecność weryfikacji podpisu i uwzględniania przetworzonych identyfikatorów.
- Dla integracji bez webhooków przepisz odpytywanie według listy kontrolnej z szóstego rozdziału i zmierz, jak zmieniła się liczba zapytań i opóźnienie.
- Przejrzyj wywołania wychodzące z handlerów: gdzie potrzebny jest stabilny adres regionalny lub izolacja limitów, podłącz proxy z osobną sesją i jawnymi timeoutami.
- Dodaj odpytywanie kontrolne jako zabezpieczenie dla krytycznych webhooków: raz na godzinę odpytuj o zdarzenia z ostatniego interwału i porównuj z przetworzonymi.
Rozdzielenie zadań na wychodzące i przychodzące to nie pedanteria, ale sposób, by przestać tracić godziny na debugowanie tego, co z definicji działać nie może, i skierować je na to, co działać będzie.
