วิธีดึงข้อมูลปริมาณมากผ่านพร็อกซีโดยไม่ต้องเริ่มใหม่หลังการเชื่อมต่อขาด: คู่มือทีละขั้นตอน
บทความ
- บทนำ: ทำไมการดึงข้อมูลยาวนานจึงมักขาดการเชื่อมต่อเสมอ และนั่นเป็นเรื่องปกติ
- การเตรียมการเบื้องต้นและแนวคิดพื้นฐาน
- ขั้นตอนที่ 1: ดาวน์โหลดไฟล์ต่อผ่าน http ด้วย header range
- ขั้นตอนที่ 2: เช็คพอยต์สำหรับการดึงข้อมูลแบบแบ่งหน้า
- ขั้นตอนที่ 3: idempotency ของการเขียนผลลัพธ์
- ขั้นตอนที่ 4: การลบข้อมูลซ้ำโดยไม่กินหน่วยความจำ
- ขั้นตอนที่ 5: การทำงานแบบขนานโดยไม่สูญเสีย
- ขั้นตอนที่ 6: การทำต่อหลังหยุดพักนาน
- ขั้นตอนที่ 7: โครงตัวโหลดข้อมูลที่ทนทานด้วย python พร้อมใช้งาน
- ข้อผิดพลาดทั่วไปและวิธีแก้
- Faq: คำถามที่พบบ่อยเกี่ยวกับการดึงข้อมูลที่ทนทาน
- บทสรุป
บทนำ: ทำไมการดึงข้อมูลยาวนานจึงมักขาดการเชื่อมต่อเสมอ และนั่นเป็นเรื่องปกติ
ถ้าคุณเคยดึงข้อมูลหลายล้านระเบียนหรือไฟล์ขนาดหลายสิบ gigabyte ผ่านพร็อกซี คุณคงรู้จักความรู้สึกนี้ดี สคริปต์ทำงานมาหกชั่วโมง แสดงความคืบหน้า 83 เปอร์เซ็นต์ แล้วก็ล้มลงด้วยข้อผิดพลาดการเชื่อมต่อ และสิ่งที่คุณมีก็แค่ไฟล์ที่ไม่สมบูรณ์กับความเข้าใจว่าต้องเริ่มใหม่ตั้งแต่ต้น
สิ่งแรกที่ต้องยอมรับคือ การดึงข้อมูลยาวนานจะขาดการเชื่อมต่อเสมอ ไม่ใช่ "บางครั้ง" ไม่ใช่ "เมื่อเครือข่ายไม่ดี" แต่เสมอ ถ้ามันใช้เวลานานพอ สาเหตุนับสิบ และส่วนใหญ่你也ควบคุมไม่ได้:
- พร็อกซีเปลี่ยน IP ภายนอก สำหรับพร็อกซีมือถือของ Proxeon นี่คือพฤติกรรมปกติ: หมุนเวียนตามเวลา或ตามคำขอ เมื่อ IP เปลี่ยน การเชื่อมต่อ TCP ที่เปิดอยู่จะถูกตัดขาด และเซิร์ฟเวอร์ต้นทางจะเห็นลูกค้าคนละคน
- เซิร์ฟเวอร์ต้นทางปิดการเชื่อมต่อตาม timeout ของตัวเอง รีสตาร์ท อัปเดต หรือแค่ตอบข้อผิดพลาด 5xx
- โปรเซสของคุณเองรีสตาร์ท: อัปเดตระบบ ดิสก์เต็ม ข้อผิดพลาดในโค้ดกับระเบียนที่ผิดปกติ หรือกด Ctrl+C โดยบังเอิญ
- โทเคนการรับรองหมดอายุ เซสชันหมดอายุ เคอร์เซอร์การดึงข้อมูลแบบแบ่งหน้าเก่าเกินไป
- โน้ตบุ๊กเข้าสู่โหมดสลีป Wi-Fi สลับไปยังจุดอื่น ผู้ให้บริการเปลี่ยนเส้นทาง
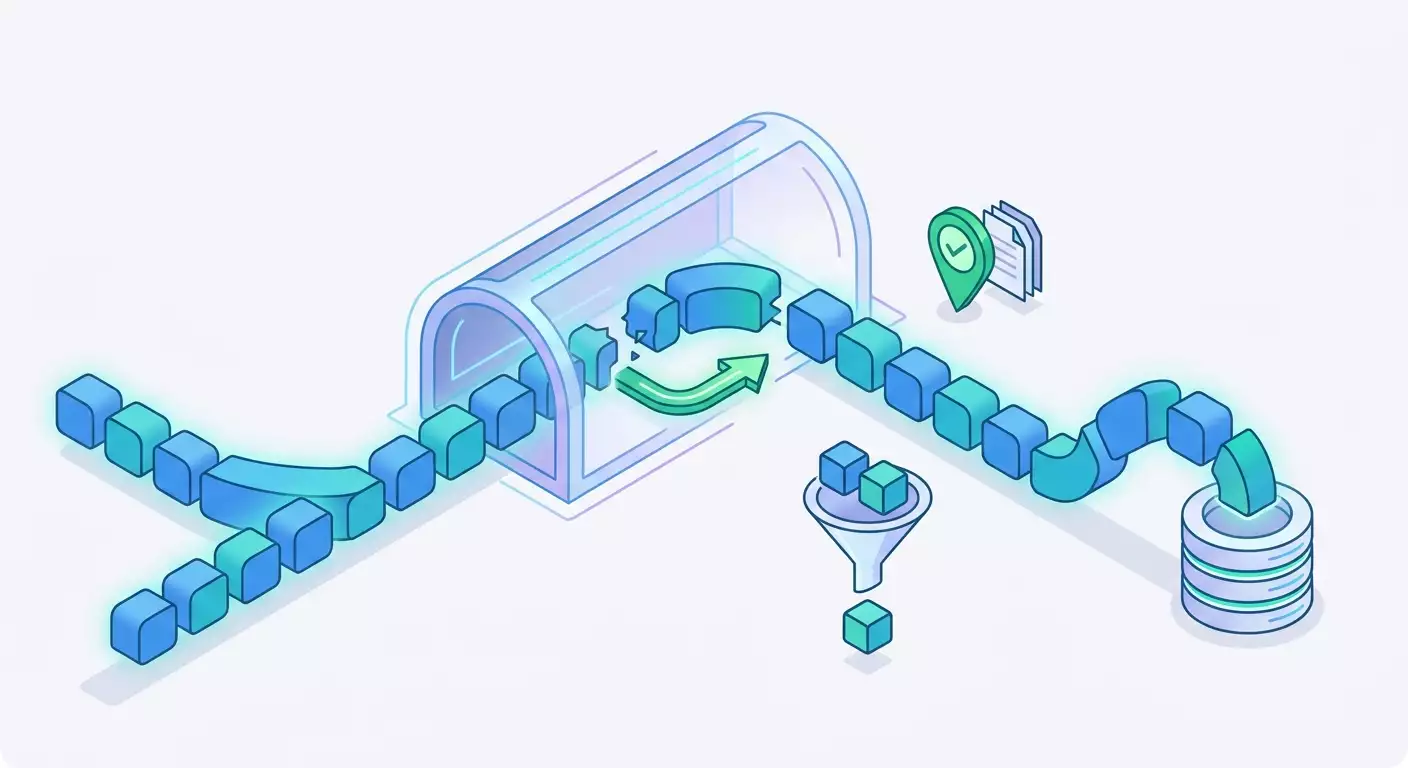
การต่อสู้กับแต่ละสาเหตุแยกกันนั้นไร้ความหมาย แนวทางที่ถูกต้องคือ: ออกแบบการดึงข้อมูลให้การขาดการเชื่อมต่อในทุกจุดต้องแลกด้วยเวลาหนึ่งหน้า或หนึ่งส่วนของไฟล์ ไม่ใช่หกชั่วโมง และนั่นคือสิ่งที่คู่มือนี้ว่าด้วย
สิ่งที่คุณจะได้ในตอนท้าย
หลังจากทำตามคำแนะนำเสร็จ คุณจะมี:
- ฟังก์ชันดาวน์โหลดต่อไฟล์จากตรงกลางผ่านโปรโตคอล HTTP ด้วย header Range พร้อมการตรวจสอบว่าเซิร์ฟเวอร์รองรับ
- รูปแบบเช็คพอยต์ที่ชัดเจนสำหรับการดึงข้อมูลแบบแบ่งหน้า: จะเก็บอะไรและเก็บสถานะที่ไหน เพื่อไม่ให้สูญหายไปกับโปรเซส
- การเขียนผลลัพธ์แบบ idempotent ที่การโหลดหน้าเดิมซ้ำไม่สร้างข้อมูลซ้ำ
- การลบข้อมูลซ้ำที่ไม่กิน RAM ทั้งหมดกับหลายล้านแถว
- ตัวโหลดข้อมูลแบบขนานพร้อมคิวงาน การลองซ้ำงานที่ล้มเหลว และการจำกัดการทำงานพร้อมกัน
- โครงตัวโหลดข้อมูลที่ทนทานด้วย Python พร้อมใช้งาน ที่คุณปรับใช้กับแหล่งข้อมูลของคุณได้ในหนึ่งชั่วโมง
คู่มือนี้เหมาะกับใคร
สำหรับนักพัฒนาและนักวิเคราะห์ที่ส่ง HTTP request จาก Python ได้แล้ว และเคยสูญเสียผลลัพธ์จากการดึงข้อมูลยาวนานมาอย่างน้อยหนึ่งครั้ง ระดับปานกลาง: อธิบายพื้นฐาน แต่ไม่สอนเขียนโปรแกรมตั้งแต่เริ่มต้น ผู้อ่านขั้นสูงจะพบส่วนเกี่ยวกับการเก็บ hash นอกหน่วยความจำและการเขียนแบบขนานอย่างปลอดภัยใน SQLite
สิ่งที่ต้องรู้ล่วงหน้า
- Python ในระดับฟังก์ชัน ลูป ดิกชันนารี และการจัดการข้อยกเว้น
- พื้นฐาน HTTP: method, header, status code, body คืออะไร
- ความเข้าใจทั่วไปเกี่ยวกับการตั้งพร็อกซีในไลบรารี requests
ขอชี้แจงแยกต่างหาก: เราจะไม่พูดถึง status code และกลยุทธ์การลองซ้ำด้วยการหน่วงเวลาแบบเลขชี้กำลังในที่นี้ มีบทความแยกต่างหากเกี่ยวกับข้อผิดพลาด 429 และการลองซ้ำ ในคู่มือนี้เราโฟกัสที่อื่น: สถานะของการดึงข้อมูลและการกลับมาทำต่อ การลองซ้ำตอบคำถาม "จะลองเมื่อไหร่" แต่เราตอบคำถาม "จะทำงานต่อจากตรงไหนหลังจากลองซ้ำหมดแล้วและโปรเซสตายไป"
ใช้เวลานานแค่ไหน
อ่านและรันตัวอย่างบนแหล่งข้อมูลทดสอบ: สองถึงสามชั่วโมง ปรับโครงให้เข้ากับ API หรือไฟล์เซิร์ฟเวอร์จริงของคุณ: อีกหนึ่งถึงสองชั่วโมงขึ้นอยู่กับว่าการแบ่งหน้าของคุณไม่เป็นมาตรฐานแค่ไหน รวมแล้วหนึ่งวันทำการเหลือเฟือ
การเตรียมการเบื้องต้นและแนวคิดพื้นฐาน
เครื่องมือและการเข้าถึง
- ติดตั้ง Python เวอร์ชัน 3.11 หรือใหม่กว่า ในปี 2026 สาย 3.12 และ 3.13 เป็นเวอร์ชันปัจจุบัน ตัวอย่างทั้งหมดทดสอบบนเวอร์ชันเหล่านี้ ตรวจสอบเวอร์ชัน: เปิดเทอร์มินัลและพิมพ์
python --versionถ้าเห็น 3.11 หรือสูงกว่า ทุกอย่างเรียบร้อย - ติดตั้งไลบรารี requests:
pip install requestsเวอร์ชัน 2.32 ขึ้นไปก็เพียงพอ โมดูล sqlite3 มาพร้อมไลบรารีมาตรฐานของ Python ไม่ต้องติดตั้งแยก - รับการเข้าถึงพร็อกซี เปิดแดชบอร์ดของ Proxeon เลือกช่องทางที่ต้องการและคัดลอกค่าสี่ค่า: host, port, login และ password ปกติจะรวมเป็นสตริงเดียวในรูปแบบ
http://USER:PASS@HOST:PORTสตริงนี้คุณจะใช้ทุกที่ต่อไป - ใส่สตริงพร็อกซีใน environment variable ไม่ใช่ในโค้ด บน Linux และ macOS:
export PROXY_URL=http://USER:PASS@HOST:PORTบน Windows PowerShell:$env:PROXY_URL='http://USER:PASS@HOST:PORT'วิธีนี้คุณจะไม่ commit รหัสผ่านลง repository โดยบังเอิญ - ตรวจสอบว่าพร็อกซีตอบสนอง รันในเทอร์มินัล:
curl -x $PROXY_URL -I https://api.example.com/แทนที่ด้วยที่อยู่แหล่งข้อมูลของคุณ คุณควรเห็นบรรทัดที่มี status code เช่นHTTP/2 200ถ้าเห็นข้อผิดพลาดการรับรองพร็อกซี 407 ให้ตรวจสอบ login และ password อีกครั้ง
ข้อกำหนดของระบบ
เครื่องใดก็ได้ที่มี RAM ว่าง 2 GB และดิสก์ที่จุผลลัพธ์การดึงข้อมูลบวกอีก 20 เปอร์เซ็นต์สำหรับ index ของ SQLite ถ้าคุณวางแผนจะโหลดหลายล้านระเบียน ดิสก์สำคัญกว่าหน่วยความจำ: แนวทางทั้งหมดสร้างขึ้นบนหลักการที่ว่าสถานะอยู่ในดิสก์ ไม่ใช่ในตัวแปรของโปรเซส
การสำรองข้อมูล
ไฟล์สถานะที่คุณจะสร้างด้านล่าง (ในตัวอย่างคือ export.sqlite) จะกลายเป็นสิ่งที่ล้ำค่าที่สุดของงานทั้งหมด สร้างนิสัยคัดลอกก่อนทดลองกับโค้ดทุกครั้ง: cp export.sqlite export.sqlite.bak แค่ครั้งเดียวก็ช่วยคุณได้หนึ่งวันของการดึงข้อมูล
ระวัง: อย่าแก้ไขไฟล์ SQLite ด้วยมือระหว่างที่ตัวโหลดทำงาน แม้แต่การอ่านจากโปรแกรมอื่นในโหมดที่ไม่ถูกต้องก็อาจล็อกการเขียนและทำให้โปรเซสล้มได้ ถ้าต้องการดูสถานะ ให้หยุดตัวโหลดหรือใช้โหมด WAL ที่จะกล่าวถึงในส่วนเกี่ยวกับการทำงานแบบขนาน
คำศัพท์สำคัญในภาษาง่ายๆ
- เช็คพอยต์ — เครื่องหมายที่บันทึกบนดิสก์ว่า "ถึงจุดนี้ดึงและเขียนข้อมูลเสร็จแล้ว" หลังการขาดการเชื่อมต่อ ตัวโหลดจะอ่านเช็คพอยต์และทำต่อจากจุดนั้น
- เคอร์เซอร์ — สตริงทึบแสงที่ API ส่งมาพร้อมกับหน้า และต้องส่งกลับเพื่อขอหน้าถัดไป คุณไม่ได้สร้างหรือถอดรหัสเคอร์เซอร์เอง
- การดึงข้อมูลแบบแบ่งหน้าด้วย offset — เมื่อคุณขอ "หน้า 37 หน้าละ 500 ระเบียน" รูปแบบง่าย แต่เมื่อมีระเบียนใหม่ในแหล่งข้อมูล หน้าจะเลื่อน และเกิดข้อมูลซ้ำ或หายไป
- การดึงข้อมูลแบบแบ่งหน้าด้วยคีย์ (keyset) — เมื่อคุณขอ "ทั้งหมดที่มี id มากกว่า 184203 เรียงตาม id" รูปแบบที่ทนทานที่สุดสำหรับการทำต่อ ถ้าแหล่งข้อมูลรองรับ
- Idempotency — คุณสมบัติของการดำเนินการที่เมื่อทำซ้ำแล้วได้ผลลัพธ์เหมือนทำครั้งเดียว เขียนหน้าเดิมสองครั้ง แต่ในฐานข้อมูลมีเพียงครั้งเดียว
- คีย์การลบข้อมูลซ้ำ — ค่าที่ทำให้สองระเบียนถือเป็นระเบียนเดียวกัน เหมาะที่สุดถ้าเป็น id จากแหล่งข้อมูล ถ้าไม่มี คีย์จะคำนวณจาก hash ของฟิลด์ที่เสถียร
- Header Range — วิธีขอให้ HTTP server ส่งไม่ใช่ทั้งไฟล์ แต่ส่งเฉพาะส่วน เช่น byte จาก 1048576 ถึงท้ายไฟล์
- Semantics at-least-once — การรับประกันว่าทุกระเบียนจะถูกรับอย่างน้อยหนึ่งครั้ง อาจมีซ้ำ แต่ไม่มีหาย นี่คือสิ่งที่คุณจะได้หลังคู่มือนี้ และการลบข้อมูลซ้ำจะจัดการส่วนที่ซ้ำ
หลักการสำคัญ
ทั้งเจ็ดขั้นตอนด้านล่างสรุปเป็นแนวคิดเดียว: ทุกหน่วยของงานต้องเป็น atomic และทำซ้ำได้ หน่วยของงานคือ ส่วนของไฟล์ หน้าของ API หรืองานจากคิว atomic หมายถึงผลลัพธ์และเครื่องหมายว่าเสร็จสิ้นถูกบันทึกพร้อมกัน ทำซ้ำได้หมายถึงถ้าทำหน่วยเดิมสองครั้งก็ไม่มีอะไรพัง เมื่อทั้งสองคุณสมบัติครบ การขาดการเชื่อมต่อที่จุดใดก็ปลอดภัย
ขั้นตอนที่ 1: ดาวน์โหลดไฟล์ต่อผ่าน HTTP ด้วย header Range
เป้าหมายของขั้นตอนนี้: เรียนรู้การดาวน์โหลดไฟล์ขนาดใหญ่ผ่านพร็อกซีให้หลังการขาดการเชื่อมต่อ การโหลดทำต่อจาก byte ที่หยุดไป ไม่ใช่เริ่มจากศูนย์
มันทำงานอย่างไร
โปรโตคอล HTTP อนุญาตให้ลูกค้าขอส่วนของ resource ได้ โดยเพิ่ม header Range: bytes=เริ่ม- ในคำขอ โดยที่ เริ่ม คือ offset ในหน่วย byte ถ้าเซิร์ฟเวอร์รองรับคำขอแบบบางส่วน จะตอบด้วยรหัส 206 Partial Content และ header Content-Range: bytes เริ่ม-สิ้นสุด/ทั้งหมด ถ้าไม่รองรับ จะไม่สนใจ Range และส่งไฟล์ทั้งหมดด้วยรหัส 200 หน้าที่ของคุณคือแยกแยะสองกรณีนี้
การรู้ล่วงหน้าว่าเซิร์ฟเวอร์รองรับการดาวน์โหลดต่อหรือไม่นั้นช่วยได้ด้วยคำขอ HEAD: ส่งคืนเฉพาะ header โดยไม่มี body ให้ดูที่ Accept-Ranges: bytes ค่า none หรือไม่มี header มักหมายความว่าไม่มีการดาวน์โหลดต่อ แม้บางเซิร์ฟเวอร์ยังจัดการ Range ได้ถูกต้อง ดังนั้นการตรวจสอบสุดท้ายดูจาก status code
คำแนะนำทีละขั้นตอน
- ทำคำขอ HEAD ผ่านพร็อกซีและบันทึก header Accept-Ranges, Content-Length, ETag และ Last-Modified ETag จำเป็นเพื่อดูว่าไฟล์บนเซิร์ฟเวอร์เปลี่ยนไประหว่างความพยายามของคุณหรือไม่
- ดูว่ามีกี่ byte ในไฟล์โลคัลแล้ว ถ้าไม่มีไฟล์ ถือว่าเป็นศูนย์
- ถ้าขนาดโลคัลเท่ากับ Content-Length แล้ว ไฟล์สมบูรณ์ ไม่ต้องทำอะไร
- ถ้าขนาดโลคัลมากกว่าศูนย์และเซิร์ฟเวอร์ประกาศรองรับ range ให้เพิ่ม header Range ด้วยขนาดปัจจุบันในคำขอ เพิ่ม
If-Rangeพร้อม ETag ที่บันทึกไว้: เซิร์ฟเวอร์จะส่งคำตอบบางส่วนเฉพาะถ้าไฟล์ไม่เปลี่ยน มิฉะนั้นจะส่งทั้งไฟล์กลับด้วยรหัส 200 - ต้องส่ง
Accept-Encoding: identityเสมอ ถ้าไม่ส่ง เซิร์ฟเวอร์อาจใช้การบีบอัดแบบ on-the-fly และ offset ของ byte จะไม่ตรงกับไฟล์ของคุณ - เปิดไฟล์โลคัลในโหมดต่อท้าย
abถ้าได้ 206 หรือโหมดเขียนทับwbถ้าได้ 200 - อ่าน body แบบ stream ทีละก้อน 256 KB และเขียนลงดิสก์ อย่าโหลดทั้งคำตอบเข้าหน่วยความจำ
- เมื่อเสร็จเปรียบเทียบขนาดสุดท้ายกับ Content-Length ถ้าไม่ตรง แสดงว่าการเชื่อมต่อขาดเงียบๆ ต้องทำรอบเพิ่ม
โค้ดพร้อมใช้งาน
import os
import requests

PROXY_URL = os.environ['PROXY_URL'] # строка из личного кабинета Proxeon
PROXIES = {'http': PROXY_URL, 'https': PROXY_URL}


def probe(url):
r = requests.head(url, proxies=PROXIES, allow_redirects=True, timeout=30,
 headers={'Accept-Encoding': 'identity'})
r.raise_for_status()
return {
'ranges': r.headers.get('Accept-Ranges', 'none').lower(),
'length': int(r.headers.get('Content-Length', 0) or 0),
'etag': r.headers.get('ETag'),
}


def download_resumable(url, path):
meta = probe(url)
have = os.path.getsize(path) if os.path.exists(path) else 0
if meta['length'] and have >= meta['length']:
print('файл уже полный:', have, 'байт')
return True
headers = {'Accept-Encoding': 'identity'}
if have > 0 and meta['ranges'] == 'bytes':
headers['Range'] = 'bytes=%d-' % have
if meta['etag']:
headers['If-Range'] = meta['etag']
with requests.get(url, headers=headers, proxies=PROXIES, stream=True,
 timeout=(30, 120)) as r:
if r.status_code == 206:
expected = 'bytes %d-' % have
if not r.headers.get('Content-Range', '').startswith(expected):
raise IOError('сервер отдал не тот диапазон: ' + r.headers.get('Content-Range', ''))
mode = 'ab'
elif r.status_code == 200:
print('сервер отдаёт файл целиком, начинаем с нуля')
mode = 'wb'
have = 0
elif r.status_code == 416:
raise IOError('запрошенный диапазон вне файла, проверьте локальный размер')
else:
r.raise_for_status()
with open(path, mode) as f:
for chunk in r.iter_content(chunk_size=256 * 1024):
if chunk:
f.write(chunk)
have += len(chunk)
if meta['length'] and have != meta['length']:
print('обрыв: получено %d из %d' % (have, meta['length']))
return False
return True


def download_until_done(url, path, max_rounds=50):
for i in range(max_rounds):
try:
if download_resumable(url, path):
return
except (requests.ConnectionError, requests.Timeout, IOError) as e:
print('заход %d прерван: %s' % (i + 1, type(e).__name__))
# пауза перед следующим заходом: стратегия описана в статье про 429 и ретраи
raise RuntimeError('не удалось докачать файл за %d заходов' % max_rounds)


if __name__ == '__main__':
download_until_done('https://files.example.com/export-2026.csv.gz', 'export-2026.csv.gz')
สังเกตฟังก์ชัน download_until_done: ไม่มีตรรกะการรอระหว่างความพยายาม ทำแบบนี้โดยตั้งใจ ใส่กลยุทธ์การหน่วงเวลาของคุณจากบทความเกี่ยวกับการลองซ้ำตรงนั้น ที่นี่สำคัญแค่ลูป "ตรวจขนาด ดาวน์โหลดต่อ ตรวจอีกครั้ง"
คำแนะนำ: ถ้าไฟล์ถูกส่งเป็น archive อย่าแตกไฟล์ระหว่างดาวน์โหลดต่อ ให้ได้ไฟล์เต็มก่อน ตรวจขนาด และถ้าเซิร์ฟเวอร์ส่ง checksum มาให้เทียบด้วย ค่อยแตกไฟล์ gzip ที่ดาวน์โหลดมาบางส่วนดูเหมือนเสียหาย และคุณจะเสียเวลาหาข้อผิดพลาดที่ไม่มีอยู่
ผลลัพธ์ที่คาดหวัง
การตรวจสอบ: รันสคริปต์กับไฟล์ขนาดอย่างน้อย 200 MB หลังจากสิบวินาทีกด Ctrl+C ดูขนาดไฟล์โลคัล เช่น 41 943 040 byte รันสคริปต์อีกครั้ง ในคอนโซลไม่ควรมีบรรทัด "เริ่มจากศูนย์" และขนาดไฟล์ควรเพิ่มขึ้นต่อ ไม่รีเซ็ต เมื่อเสร็จขนาดสุดท้ายควรตรงกับ Content-Length จากคำขอ HEAD
ปัญหาที่อาจเกิดขึ้น
- เซิร์ฟเวอร์ส่ง 200 แทน 206 เสมอ หมายความว่าไม่รองรับการดาวน์โหลดต่อ ทางออกเดียวสำหรับแหล่งข้อมูลแบบนี้คือดาวน์โหลดทั้งไฟล์ในรอบเดียวด้วย timeout ยาว หรือหา format การดึงข้อมูลแบบแบ่งส่วนอื่นจากแหล่งข้อมูล เช่นแบ่งตามวันที่
- ไม่มี header Content-Length เซิร์ฟเวอร์ส่งไฟล์แบบ chunked โดยไม่ประกาศขนาด ตรวจสอบความสมบูรณ์ด้วยขนาดไม่ได้ ดาวน์โหลดต่อก็ไม่ได้: Range ต้องมี offset ที่รู้ ตกลงกับแหล่งข้อมูลหรือใช้ checksum ถ้ามีการเผยแพร่
- ตอบ 416 ตั้งแต่ครั้งแรก ไฟล์โลคัลใหญ่กว่าไฟล์บนเซิร์ฟเวอร์ ไฟล์บนเซิร์ฟเวอร์เปลี่ยนและสั้นลง ลบไฟล์โลคัลและเริ่มใหม่
- ขนาดตรงแต่ไฟล์เสีย น่าจะมีจุดที่การเชื่อมต่อขาดด้วยรหัส 200 และเขียนทับจากศูนย์ แล้วต่อท้าย สร้างไฟล์ใหม่ เพื่อไม่ให้เกิดซ้ำ เก็บ ETag ในไฟล์แยกข้างๆ และเทียบก่อนทุกครั้ง
ขั้นตอนที่ 2: เช็คพอยต์สำหรับการดึงข้อมูลแบบแบ่งหน้า
เป้าหมายของขั้นตอนนี้: บันทึกสถานะการดึงข้อมูลเพื่อให้หลังการล้มเหลวใดๆ โปรเซสทำต่อจากหน้าสุดท้ายที่เขียนสำเร็จ
จะเก็บอะไร
เช็คพอยต์ขั้นต่ำขึ้นอยู่กับประเภทการแบ่งหน้าของแหล่งข้อมูล เราจะพูดถึงสามกรณี
- การแบ่งหน้าด้วยเคอร์เซอร์ API ส่งฟิลด์เช่น
next_cursorมาพร้อมข้อมูล เก็บค่านั้น นี่คือกรณีที่ง่ายที่สุด: เคอร์เซอร์มีทุกอย่างที่เซิร์ฟเวอร์ต้องการเพื่อทำต่ออยู่แล้ว - การแบ่งหน้าด้วยหมายเลขหน้าหรือ offset เก็บหมายเลขหน้าสุดท้ายที่เขียนเสร็จสมบูรณ์และขนาดหน้า จำไว้ว่าเมื่อมีระเบียนใหม่เพิ่มในแหล่งข้อมูลระหว่างการดึง offset จะเลื่อน ดังนั้นการลบข้อมูลซ้ำในขั้นตอนที่ 4 จึงจำเป็น
- การแบ่งหน้าด้วยคีย์ เก็บ id ของระเบียนสุดท้ายที่เขียน เมื่อทำต่อ ขอทุกอย่างที่มากกว่า id นั้น รูปแบบไม่กลัวการแทรกหรือการหยุดพักนาน
ไม่ว่าจะเป็นการแบ่งหน้าประเภทใด ควรเพิ่มฟิลด์บริการในเช็คพอยต์: id ของระเบียนสุดท้าย (แม้ในรูปแบบเคอร์เซอร์ นี่คือสมอสำรองถ้าเคอร์เซอร์หมดอายุ) ตัวนับหน้าและแถวสำหรับติดตามความคืบหน้า เวลาเริ่มต้นการดึงข้อมูล และเวลาอัปเดตล่าสุด
จะเก็บสถานะที่ไหน
มีสองทางเลือกที่ใช้งานได้ และทั้งคู่ดีกว่าตัวแปรในหน่วยความจำ
ทางเลือก A: ไฟล์ JSON พร้อมการแทนที่แบบ atomic
เหมาะถ้าผลลัพธ์เขียนลงไฟล์แยก ไม่ใช่ฐานข้อมูล กับดักหลัก: ถ้าเขียนสถานะตรงเข้าไฟล์เป้าหมายและโปรเซสล้มกลางการเขียน คุณจะได้ JSON ที่ถูกตัดและอ่านไม่ได้ ทางแก้คือเขียนไปยังไฟล์ชั่วคราวข้างๆ และเปลี่ยนชื่อทับไฟล์หลัก การเปลี่ยนชื่อในระบบไฟล์เดียวกันเป็น atomic
import json
import os
import tempfile


def save_state(path, state):
directory = os.path.dirname(os.path.abspath(path))
fd, tmp = tempfile.mkstemp(dir=directory, prefix='.state-')
with os.fdopen(fd, 'w', encoding='utf-8') as f:
json.dump(state, f, ensure_ascii=False)
f.flush()
os.fsync(f.fileno())
os.replace(tmp, path)


def load_state(path, default):
if not os.path.exists(path):
return dict(default)
with open(path, encoding='utf-8') as f:
return json.load(f)
ทางเลือก B: ตารางใน SQLite ข้างๆ ข้อมูล
ทางเลือกที่ต้องการถ้าคุณเก็บระเบียนในฐานข้อมูล เช็คพอยต์อัปเดต ใน transaction เดียวกัน กับการแทรกแถวของหน้า อย่างใดอย่างหนึ่ง: ทั้งข้อมูลและเครื่องหมายถูกบันทึก หรือไม่บันทึกเลย ไม่มีช่องว่างระหว่าง "มีข้อมูล ไม่มีเครื่องหมาย" โดยหลักการ
import sqlite3

con = sqlite3.connect('export.sqlite')
con.executescript('''
CREATE TABLE IF NOT EXISTS records(
id TEXT PRIMARY KEY,
payload TEXT NOT NULL,
fetched_at TEXT NOT NULL
);
CREATE TABLE IF NOT EXISTS checkpoint(
job TEXT PRIMARY KEY,
cursor TEXT,
last_id TEXT,
pages INTEGER NOT NULL DEFAULT 0,
updated_at TEXT
);
''')


def commit_page(job, rows, next_cursor, pages, ts):
with con: # одна транзакция на страницу
con.executemany(
'INSERT OR IGNORE INTO records(id, payload, fetched_at) VALUES (?, ?, ?)',
[(str(r['id']), json.dumps(r, ensure_ascii=False), ts) for r in rows])
con.execute(
'INSERT INTO checkpoint(job, cursor, last_id, pages, updated_at) VALUES (?, ?, ?, ?, ?) '
'ON CONFLICT(job) DO UPDATE SET cursor=excluded.cursor, last_id=excluded.last_id, '
'pages=excluded.pages, updated_at=excluded.updated_at',
(job, next_cursor, str(rows[-1]['id']), pages, ts))
ลำดับการดำเนินการ
จำกฎไว้: ข้อมูลก่อน แล้วเช็คพอยต์ และควรอยู่ใน transaction เดียวกัน ถ้าใช้ transaction ไม่ได้ (เช่นข้อมูลเขียนลงไฟล์) ลำดับคือ: เขียนไฟล์หน้า, sync ลงดิสก์, แล้วอัปเดตสถานะ เมื่อล้มระหว่างสองการกระทำนี้ คุณจะได้การโหลดหน้าหนึ่งซ้ำ ซึ่งปลอดภัย thanks to ขั้นตอนที่ 3 ลำดับกลับกันจะทำให้หน้าหายไป ซึ่งเป็นการสูญเสียข้อมูล
คำแนะนำ: เก็บในเช็คพอยต์ไม่ใช่เคอร์เซอร์ปัจจุบัน แต่เป็นเคอร์เซอร์ของหน้าถัดไปที่เซิร์ฟเวอร์ส่งกลับ เมื่อทำต่อคุณจะขอสิ่งที่ยังไม่มีทันที โดยไม่ต้องขอหน้าที่ได้แล้วซ้ำ
ผลลัพธ์ที่คาดหวัง
การตรวจสอบ: รันการดึงข้อมูล รอจนถึงสิบคหน้า แล้วบังคับให้โปรเซสจบ เปิดฐานข้อมูลด้วยคำสั่ง sqlite3 export.sqlite และรัน SELECT pages, last_id FROM checkpoint; คุณควรเห็นเลข 10 และ id จากนั้นรัน SELECT count(*) FROM records; และตรวจว่าจำนวนระเบียนเท่ากับสิบเท่าของขนาดหน้า รันตัวโหลดอีกครั้ง: ข้อความแรกในคอนโซลควรเป็นอะไรทำนอง "เริ่ม: หน้า 10"
ปัญหาที่อาจเกิดขึ้น
- ข้อผิดพลาด "database is locked" โปรเซสอื่นถือการเชื่อมต่ออยู่ ปิดหน้าต่าง sqlite3 ทั้งหมดและเครื่องมืออื่นที่เปิดไฟล์ สำหรับการทำงานแบบหลายเธรด เปิดโหมด WAL ดูขั้นตอนที่ 5
- เคอร์เซอร์ถูกบันทึก แต่ข้อมูลไม่ คุณอัปเดตเช็คพอยต์นอก transaction กับข้อมูล กลับไปที่โค้ดด้านบนและตรวจว่าทั้งสองการดำเนินการอยู่ในบล็อก
with con:เดียวกัน - JSON สถานะว่างหรือเสีย คุณเขียนตรงเข้าไฟล์โดยไม่ใช้ไฟล์ชั่วคราวและเปลี่ยนชื่อ ใช้ฟังก์ชัน save_state ทั้งหมด
ขั้นตอนที่ 3: Idempotency ของการเขียนผลลัพธ์
เป้าหมายของขั้นตอนนี้: ทำให้การประมวลผลหน้าใดซ้ำไม่สร้างข้อมูลซ้ำและไม่ทำให้ข้อมูลเสีย
ทำไมการซ้ำจึงหลีกเลี่ยงไม่ได้
หลังจากขั้นตอนที่ 2 คุณเห็นสถานการณ์ที่หน้าเขียนสองครั้งแล้ว: โปรเซสล้มหลังแทรกข้อมูล แต่ก่อนอัปเดตเช็คพอยต์ นอกจากนี้ การซ้ำยังมาจากการแบ่งหน้าด้วย offset เมื่อแหล่งข้อมูลเปลี่ยน จาก worker แบบขนานที่ได้งานเดียวกันหลังรีสตาร์ท และจากการรีสตาร์ทด้วยมือ "เผื่อไว้" การต่อสู้กับการซ้ำฝั่งคำขอไร้ประโยชน์ วิธีที่ถูกคือทำให้การเขียนเองปลอดภัยต่อการซ้ำ
การเลือกคีย์การลบข้อมูลซ้ำ
- มี id จากแหล่งข้อมูล ใช้มัน นี่คือฟิลด์
id,uuid,order_numberหรือคล้ายกันที่แหล่งข้อมูลรับประกันว่าไม่ซ้ำ ถ้าดึงจากหลายแหล่งลงตารางเดียว ใช้คีย์ผสม: ชื่อแหล่งบวก id - ไม่มี id แต่มีชุดฟิลด์ที่รวมกันระบุระเบียน เช่นสำหรับแถว price list คือ รหัสสินค้า บวก คลัง บวก วันที่ สร้างคีย์จากฟิลด์เหล่านี้โดย normalize: ทำให้สตริงเป็นตัวพิมพ์เดียวกัน ตัดช่องว่างหัวท้าย แปลงวันที่เป็นรูปแบบเดียว
- ไม่มีอะไรเสถียร แล้วคีย์กลายเป็น hash ของทั้งระเบียนหลังการ canonicalize กรณีนี้จะอธิบายละเอียดในขั้นตอนที่ 4 จำไว้ว่าถ้าแหล่งข้อมูลเปลี่ยนระเบียน (อัปเดตราคา) hash จะเปลี่ยน และคุณจะได้ทั้งสองเวอร์ชัน บางครั้งนั่นคือสิ่งที่ต้องการ บางครั้งไม่
ระวัง: อย่าใช้ลำดับแถวในคำตอบหรือหมายเลขหน้าเป็นคีย์ ค่าเหล่านี้เปลี่ยนเมื่อแหล่งข้อมูลเปลี่ยน และการลบข้อมูลซ้ำจะกลายเป็นเครื่องสร้างข้อมูลซ้ำ
การแทรกแบบ idempotent ในฐานข้อมูล
ใน SQLite และฐานข้อมูลเชิงสัมพันธ์ส่วนใหญ่มีโครงสร้างที่ либо ไม่สนใจความขัดแย้งของ primary key หรืออัปเดตแถวที่มีอยู่ ตัวเลือกแรก INSERT OR IGNORE คุณเห็นแล้วในขั้นตอนที่ 2 เหมาะเมื่อระเบียนไม่เปลี่ยน ตัวเลือกที่สองจำเป็นถ้าแหล่งข้อมูลอัปเดตระเบียนและคุณต้องการเวอร์ชันล่าสุด:
def upsert_rows(con, rows, ts):
con.executemany(
'INSERT INTO records(id, payload, fetched_at) VALUES (?, ?, ?) '
'ON CONFLICT(id) DO UPDATE SET payload=excluded.payload, fetched_at=excluded.fetched_at',
[(str(r['id']), json.dumps(r, ensure_ascii=False), ts) for r in rows])
การเขียนลงไฟล์แบบ idempotent
ถ้าผลลัพธ์ต้องอยู่ในไฟล์ ไม่ใช่ฐานข้อมูล ใช้หลักการเดียวกัน: หนึ่งหน้าเท่ากับหนึ่งไฟล์ที่มีชื่อ deterministic ชื่อขึ้นอยู่กับพารามิเตอร์ของหน้า ไม่ใช่เวลาหรือตัวนับ ก่อนโหลดตรวจว่าไฟล์ปลายทางมีอยู่แล้วหรือไม่ ถ้ามี ข้ามหน้าไป เขียนไปยังชื่อชั่วคราวและเปลี่ยนชื่อเมื่อเสร็จ เหมือนในฟังก์ชัน save_state
def page_path(base_dir, job, cursor_or_page):
safe = str(cursor_or_page).replace('/', '_').replace(':', '_')[:120]
return os.path.join(base_dir, job, 'page-%s.jsonl' % safe)


def write_page_idempotent(path, rows):
if os.path.exists(path):
return False # страница уже есть, повторная запись не нужна
os.makedirs(os.path.dirname(path), exist_ok=True)
tmp = path + '.part'
with open(tmp, 'w', encoding='utf-8') as f:
for r in rows:
f.write(json.dumps(r, ensure_ascii=False))
f.write(chr(10))
f.flush()
os.fsync(f.fileno())
os.replace(tmp, path)
return True
ไฟล์ที่มีนามสกุล .part ที่เหลือหลังล้มเหลว ลบได้เลยตอนเริ่ม: ตามนิยามแล้วไม่สมบูรณ์
คำแนะนำ: สำหรับการดึงข้อมูลด้วย offset อย่าพึ่งแค่ "ไฟล์มีอยู่ หน้าเสร็จแล้ว" ตรวจเพิ่มว่าจำนวนแถวในไฟล์เท่ากับขนาดหน้า (ยกเว้นหน้าสุดท้าย) ไฟล์ว่างหรือสั้นที่ชื่อมีอยู่ควรโหลดใหม่
ผลลัพธ์ที่คาดหวัง
การตรวจสอบ: เรียกฟังก์ชันเขียนหน้าเดิมสามครั้งติดกัน จากนั้นรัน SELECT count(*) FROM records; จำนวนควรเท่ากับขนาดหนึ่งหน้า ไม่ใช่สามเท่า สำหรับทางเลือกไฟล์ ในไดเรกทอรีควรมีไฟล์หน้าหนึ่งไฟล์และไม่มีไฟล์ .part
ขั้นตอนที่ 4: การลบข้อมูลซ้ำโดยไม่กินหน่วยความจำ
เป้าหมายของขั้นตอนนี้: กรองระเบียนซ้ำในสตรีมหลายล้านแถว โดยไม่เก็บคีย์ทั้งหมดใน RAM
Hash ของระเบียน
เมื่อระเบียนไม่มี id คีย์จะกลายเป็น hash ของเนื้อหา เพื่อให้ระเบียนเหมือนกันได้ hash เหมือนกัน เนื้อหาต้อง canonicalize: เรียงคีย์ของ dict ตัดช่องว่างส่วนเกิน กำหนดตัวคั่น มิฉะนั้นระเบียนเดียวกันที่มาในลำดับฟิลด์ต่างกันจะได้ hash ต่างกัน
import hashlib
import json


def record_key(rec, fields=None):
src = rec if fields is None else {k: rec.get(k) for k in fields}
canon = json.dumps(src, sort_keys=True, ensure_ascii=False, separators=(',', ':'))
return hashlib.blake2b(canon.encode('utf-8'), digest_size=16).digest()
ฟังก์ชันส่งคืน 16 byte เพียงพอ: ความน่าจะเป็นของการชนกันแบบสุ่มสำหรับหลายร้อยล้านระเบียนนั้นน้อยมาก พารามิเตอร์ fields ให้คำนวณ hash เฉพาะฟิลด์ที่เสถียร เช่น ตัดเวลาอัปเดตล่าสุดที่เปลี่ยนทุกคำขอออก
ทำไม set ในหน่วยความจำใช้กับหลายล้านไม่ไหว
สิ่งแรกที่นึกถึง: สร้าง seen = set() และเก็บคีย์ไว้ มาคำนวณกัน วัตถุ bytes ขนาด 16 byte ใน Python ใช้ประมาณ 49 byte บวกข้อมูลจริง รวมประมาณ 65 byte slot ใน set รวมกับ load factor เพิ่มอีกประมาณ 30 byte รวมประมาณ 95 byte ต่อคีย์ สำหรับ 10 ล้านระเบียนคือ ประมาณ 950 MB สำหรับ 50 ล้านเกือบ 5 GB และที่สำคัญที่สุด: หลังรีสตาร์ทโปรเซส set ว่างเปล่า และการลบข้อมูลซ้ำเริ่มจากศูนย์ใหม่
สามวิธีที่ไม่ทำให้หน่วยความจำบวม
- เก็บคีย์ในฐานข้อมูลเอง วิธีที่ง่ายและเชื่อถือได้ที่สุด ถ้าคีย์เป็น primary key ของตาราง records การลบข้อมูลซ้ำทำเสร็จแล้วด้วย
INSERT OR IGNOREจากขั้นตอนที่ 3 index อยู่ในดิสก์ รอดจากการรีสตาร์ท และ SQLite cache หน้า index ที่ร้อนเอง สำหรับ 10 ล้านคีย์ขนาด 16 byte index จะใช้ประมาณ 400-500 MB บนดิสก์ แต่ไม่ใช่ในหน่วยความจำ - ตาราง seen แยกแบบไม่มี rowid จำเป็นถ้าเขียนข้อมูลเองไม่ใช่ใน SQLite แต่เช่นในไฟล์ แล้วใช้ SQLite เป็นแค่ set ขนาดกะทัดรัดบนดิสก์
- set แบบบีบอัดในหน่วยความจำเป็น prefiter ทางเลือกขั้นสูง: ตัด hash เหลือ 8 byte และเก็บเป็น integer ใน array ที่เรียงแล้ว หรือใช้ Bloom filter หน่วยความจำลดลงหลายเท่า แต่มีโอกาส false positive จึงใช้เป็น prefiter เพื่อตัดระเบียนใหม่ที่แน่นอนเท่านั้น และตรวจสุดท้ายกับฐานข้อมูลเสมอ
การสร้าง set บนดิสก์
class DiskSeen:
def __init__(self, con):
self.con = con
con.execute('CREATE TABLE IF NOT EXISTS seen(key BLOB PRIMARY KEY) WITHOUT ROWID')

def filter_new(self, rows):
keyed = [(record_key(r), r) for r in rows]
keys = [k for k, _ in keyed]
placeholders = ','.join('?' * len(keys))
known = {row[0] for row in self.con.execute(
'SELECT key FROM seen WHERE key IN (%s)' % placeholders, keys)}
fresh = [(k, r) for k, r in keyed if k not in known]
# дедупликация внутри самой страницы
unique = {}
for k, r in fresh:
unique.setdefault(k, r)
return unique

def remember(self, keys):
self.con.executemany('INSERT OR IGNORE INTO seen(key) VALUES (?)', [(k,) for k in keys])
เรียก filter_new ก่อนเขียนหน้า และ remember ใน transaction เดียวกันกับการเขียนข้อมูลและเช็คพอยต์ จากนั้นหลังล้มเหลว set ที่เห็นแล้ว ข้อมูล และเครื่องหมายความคืบหน้าจะสอดคล้องกันเสมอ
คำแนะนำ: คำขอด้วย IN กับ 500 ค่า ทำงานผ่าน index ในหลักมิลลิวินาที อย่าตรวจคีย์ทีละตัวในลูป: ช้ากว่าหลายสิบเท่าเพราะ overhead ของแต่ละคำขอ
ผลลัพธ์ที่คาดหวัง
การตรวจสอบ: สร้างหน้าทดสอบ 500 ระเบียน โดย 100 ซ้ำกันสองครั้งในหน้า และอีก 100 มีอยู่ในตาราง seen แล้ว ฟังก์ชัน filter_new ควรคืน 300 ระเบียนพอดี หลังรีสตาร์ทโปรเซส 500 ระเบียนเดิมควรให้ศูนย์ใหม่
ปัญหาที่อาจเกิดขึ้น
- ข้อมูลซ้ำยังผ่าน ตรวจ canonicalization: น่าจะมีฟิลด์เวลาคำขอหรือลำดับสุ่มของ elements ใน list ตัดออกด้วยพารามิเตอร์ fields หรือเรียง list ซ้อนก่อน hash
- การแทรกช้าหลังหลายล้านแถว index ไม่พอดีใน cache อีกต่อไป เพิ่ม cache SQLite ด้วยคำสั่ง
PRAGMA cache_size=-200000(นี่คือ 200 MB) และตรวจว่าแทรกเป็นชุดใน transaction หนึ่งต่อหน้า ไม่ใช่ทีละแถว
ขั้นตอนที่ 5: การทำงานแบบขนานโดยไม่สูญเสีย
เป้าหมายของขั้นตอนนี้: เร่งการดึงข้อมูลด้วย worker หลายตัวพร้อมกันผ่านพร็อกซี โดยการล้มเหลวของตัวใดก็ไม่ทำให้งานหายและไม่ทำให้ฐานข้อมูลเสีย
เมื่อไหร่ขนานได้ เมื่อไหร่ไม่ได้
การแบ่งหน้าด้วยเคอร์เซอร์โดยธรรมชาติเป็นลำดับ: เคอร์เซอร์ถัดไปรู้หลังได้หน้าก่อนหน้า ขนานโดยตรงไม่ได้ แต่เกือบเสมอเราสามารถแบ่งการดึงข้อมูลเป็น shard อิสระ: ตามวัน ตามหมวดหมู่ ตามภูมิภาค ตามอักขระแรกของ id แต่ละ shard ดึงแบบลำดับด้วยเช็คพอยต์ของตัวเอง และ shard ทำงานขนานกัน การแบ่งหน้าด้วย offset และด้วยคีย์ที่มีขอบเขตชัดเจนขนานได้โดยตรง: งานเช่น "หน้า 1 ถึง 100" หรือ "id 0 ถึง 100000"
คิวงานบนดิสก์
คิวในหน่วยความจำตายไปกับโปรเซส ดังนั้นงานจึงอยู่ในตารางที่มีสถานะ:
pending— รอทำงาน;running— worker หยิบไปแล้ว;done— ทำเสร็จและบันทึกแล้ว;failed— หมดความพยายาม ต้องให้คนดู
ตอนเริ่ม ตัวโหลดเปลี่ยนงานทั้งหมดจาก running กลับเป็น pending ก่อน: ถ้าค้างในสถานะนี้ แสดงว่าโปรเซสก่อนตายกลางทาง จากนั้น worker ดึง pending ไป
จุดเขียนเดียว
SQLite อนุญาตให้ผู้อ่านหลายตัวพร้อมกัน แต่ผู้เขียนเพียงตัวเดียว รูปแบบที่ง่ายและปลอดภัยที่สุด: worker ดาวน์โหลดและส่งคืนข้อมูลเท่านั้น และ main thread เป็นผู้เขียนลงฐานข้อมูลทั้งหมด ไม่มี lock ในโค้ด ไม่มี "database is locked" เพิ่มเปิดโหมด WAL เพื่อให้การอ่านสถานะจากโปรเซสอื่นไม่ขัดขวางการเขียน
การจำกัดการทำงานพร้อมกัน
จำกัดจำนวน worker ด้วยสองสิ่ง อย่างแรก: ความสามารถของพร็อกซี ถ้าในแดชบอร์ด Proxeon คุณมีหลายช่องทาง ควรมี worker หนึ่งถึงสองตัวต่อช่องทาง เพื่อการหมุน IP ในช่องทางหนึ่งไม่ตัดการเชื่อมต่อของทุก thread พร้อมกัน อย่างที่สอง: ความสุภาพต่อแหล่งข้อมูล แม้ไม่มีลิมิตอย่างเป็นทางการ สิบ thread ขนานกับ API เล็กๆ จะสร้างโหลดที่ทำให้ถูกปฏิเสธ เริ่มจากสามถึงสี่ worker และเพิ่มเมื่อสังเกตอัตราข้อผิดพลาด
โค้ดตัวโหลดแบบขนาน
import json
import sqlite3
from concurrent.futures import ThreadPoolExecutor, as_completed


def init_tasks(con):
con.execute('PRAGMA journal_mode=WAL')
con.executescript('''
CREATE TABLE IF NOT EXISTS tasks(
task_id TEXT PRIMARY KEY,
params TEXT NOT NULL,
status TEXT NOT NULL DEFAULT 'pending',
attempts INTEGER NOT NULL DEFAULT 0,
last_error TEXT
);
''')
with con:
con.execute('UPDATE tasks SET status=? WHERE status=?', ('pending', 'running'))


def enqueue(con, tasks):
with con:
con.executemany('INSERT OR IGNORE INTO tasks(task_id, params) VALUES (?, ?)',
[(t['task_id'], json.dumps(t['params'])) for t in tasks])


def claim(con, limit):
rows = con.execute('SELECT task_id, params FROM tasks WHERE status=? LIMIT ?',
 ('pending', limit)).fetchall()
with con:
con.executemany('UPDATE tasks SET status=? WHERE task_id=?',
[('running', r[0]) for r in rows])
return [(r[0], json.loads(r[1])) for r in rows]


def run_parallel(con, fetch_fn, write_fn, workers=4, max_attempts=5):
init_tasks(con)
with ThreadPoolExecutor(max_workers=workers) as pool:
while True:
batch = claim(con, workers * 2)
if not batch:
break
futures = {pool.submit(fetch_fn, params): task_id for task_id, params in batch}
for fut in as_completed(futures):
task_id = futures[fut]
try:
rows = fut.result()
except Exception as e:
with con:
con.execute(
'UPDATE tasks SET attempts=attempts+1, last_error=?, '
'status=CASE WHEN attempts+1 >= ? THEN ? ELSE ? END WHERE task_id=?',
(str(e)[:500], max_attempts, 'failed', 'pending', task_id))
continue
with con: # данные и статус задания в одной транзакции
write_fn(con, rows)
con.execute('UPDATE tasks SET status=? WHERE task_id=?', ('done', task_id))
failed = con.execute('SELECT count(*) FROM tasks WHERE status=?', ('failed',)).fetchone()[0]
print('очередь пуста, заданий с ошибкой:', failed)
ฟังก์ชัน fetch_fn ส่งคำขอผ่านพร็อกซีและคืน list ของระเบียน ทำงานใน thread และไม่แตะฐานข้อมูล ฟังก์ชัน write_fn ถูกเรียกใน main thread ภายใน transaction และทำการแทรกแบบ idempotent จากขั้นตอนที่ 3 งานที่ล้มเหลวจะกลับเป็น pending อัตโนมัติและถูกหยิบอีกครั้งในรอบ claim ถัดไป หลังหมดความพยายามจะได้สถานะ failed และคุณจัดการด้วยมือ
ระวัง: อย่าส่ง object การเชื่อมต่อ sqlite3 เข้า worker การเชื่อมต่อผูกกับ thread ที่สร้าง และการใช้จาก thread อื่นจะทำให้เกิดข้อผิดพลาด หรือที่แย่กว่าคือข้อมูลเสียหายเงียบๆ แต่ละ thread ต้องมี connection ของตัวเอง หรือเหมือนในตัวอย่างด้านบน ไม่มีเลย
คำแนะนำ: ใช้ object requests.Session แยกสำหรับแต่ละ worker ที่มีที่อยู่พร็อกซีของตัวเอง ถ้าคุณมีหลายช่องทางใน Proxeon กระจายตาม worker แบบวน: worker 0 ใช้ช่องทาง 0, worker 1 ใช้ช่องทาง 1 ไปเรื่อยๆ วิธีนี้การเชื่อมต่อขาดในช่องทางหนึ่งจะกระทบเพียง thread เดียว
ผลลัพธ์ที่คาดหวัง
การตรวจสอบ: ใส่ 100 งานในคิว เริ่มสี่ worker และฆ่าโปรเซสหลังครึ่งนาที รัน SELECT status, count(*) FROM tasks GROUP BY status; คุณจะเห็น done หลายรายการ running หลายรายการ และ pending ที่เหลือ เริ่มอีกครั้ง: running ควรหายไปตอนเริ่ม และเมื่อเสร็จทั้งหมดควรอยู่ใน done ยกเว้นที่ล้มจริงและอยู่ใน failed พร้อมข้อความข้อผิดพลาดใน last_error
ขั้นตอนที่ 6: การทำต่อหลังหยุดพักนาน
เป้าหมายของขั้นตอนนี้: ทำต่อการดึงข้อมูลที่หยุดไปหลายชั่วโมงหรือหลายวันอย่างถูกต้อง และไม่สะดุดกับสถานะที่หมดอายุ
อะไรหมดอายุ
การทำต่อหลังสิบวินาทีกับหลังหนึ่งสัปดาห์เป็นงานต่างกัน หลังหยุดพักนาน ส่วนหนึ่งของสถานะที่บันทึกไว้ใช้ไม่ได้อีกต่อไป
- เซสชันและ cookies เซสชันฝั่งเซิร์ฟเวอร์มักมีอายุหลายชั่วโมงถึงหนึ่งวัน cookies ที่บันทึกไว้หลังจากนั้นจะนำไปสู่ 401 หรือ redirect ไปหน้า login ทางแก้: ตอนเริ่มทำการรับรองใหม่ทั้งหมด ไม่ใช่กู้คืน cookies จากไฟล์
- โทเคนการเข้าถึง โทเคน OAuth มีอายุหนึ่งชั่วโมง บางทีน้อยกว่า ถ้ามี refresh token ให้อัปเดต access token ก่อนเริ่มและตามตารางระหว่างทำงาน ไม่ต้องรอให้ถูกปฏิเสธ
- เคอร์เซอร์การแบ่งหน้า API หลายแห่งจำกัดอายุเคอร์เซอร์เป็นนาทีหรือชั่วโมง เคอร์เซอร์หมดอายุจะคืนข้อผิดพลาด 400 พร้อมข้อความว่าเคอร์เซอร์ไม่ถูกต้อง นี่คือเหตุผลที่ในขั้นตอนที่ 2 เราเก็บสมอสำรอง: id ของระเบียนสุดท้าย ถ้าแหล่งข้อมูลรองรับฟิลเตอร์ตาม id หรือตามเวลาที่แก้ไข สร้างคำขอใหม่จากสมอนี้ ถ้าไม่รองรับ ต้องเริ่ม shard ใหม่ และการลบข้อมูลซ้ำจากขั้นตอนที่ 4 จะกรองส่วนที่ได้แล้ว
- เนื้อหาไฟล์บนเซิร์ฟเวอร์ สำหรับการดาวน์โหลดต่อจากขั้นตอนที่ 1 สำคัญที่ไฟล์ไม่เปลี่ยน เทียบ ETag ปัจจุบันกับที่บันทึกไว้ก่อนทุกครั้ง ถ้าไม่ตรง ให้เริ่มไฟล์ใหม่
- การตั้งค่าพร็อกซี ภายในหนึ่งสัปดาห์ port รหัสผ่าน หรืออายุช่องทางในแดชบอร์ด Proxeon อาจเปลี่ยน ตรวจสอบพร็อกซีด้วยคำขอทดสอบก่อนเริ่มจัดการคิว
- ชุดข้อมูลเอง ถ้าการดึงข้อมูลใช้เวลาหนึ่งสัปดาห์ และแหล่งข้อมูลเพิ่มและลบระเบียนในระหว่างนั้น ผลลัพธ์ของคุณจะเป็นส่วนผสมของสถานะในเวลาต่างกัน สำหรับงานหลายอย่างยอมรับได้ ถ้าไม่ ให้เก็บเวลาเริ่มในเช็คพอยต์และหลังเสร็จทำรอบเพิ่ม incremental สำหรับระเบียนที่เปลี่ยนหลังเวลานั้น
การตรวจสอบก่อนบิน
รวบรวมการตรวจสอบทั้งหมดในฟังก์ชันเดียวที่รันตอนเริ่มก่อนทำงานจริงใดๆ มันจะจัดสถานะให้เรียบร้อย หรือหยุดตัวโหลดพร้อมข้อความที่ชัดเจน
def preflight(session, state, probe_url):
# 1. прокси жив и авторизован
r = session.head(probe_url, timeout=20)
if r.status_code == 407:
raise SystemExit('прокси отверг логин или пароль, проверьте данные в кабинете Proxeon')
# 2. токен доступа свежий
refresh_access_token(session)
# 3. курсор ещё действителен
if state['cursor']:
test = session.get(API_BASE + '/orders', params={'cursor': state['cursor'], 'limit': 1}, timeout=30)
if test.status_code == 400 and 'cursor' in test.text.lower():
print('курсор протух, переключаемся на якорь по last_id =', state['last_id'])
state['cursor'] = None
state['resume_after_id'] = state['last_id']
# 4. напоминание о возрасте выгрузки
print('выгрузка стартовала', state['started_at'], 'страниц записано', state['pages'])
return state
ฟังก์ชัน refresh_access_token ขึ้นอยู่กับแหล่งข้อมูลของคุณ: ปกติเป็นคำขอ POST พร้อม refresh token หลังจากนั้นอัปเดต header Authorization ในเซสชัน ฟิลด์ resume_after_id ใช้ในฟังก์ชันรับหน้าเป็นฟิลเตอร์ "id มากกว่าที่ระบุ"
คำแนะนำ: เก็บ refresh token และรหัสผ่านพร็อกซีไม่ใช่ในเช็คพอยต์ แต่ใน environment variable หรือไฟล์ secrets แยกที่มีสิทธิ์จำกัด เช็คพอยต์คุณจะคัดลอก ส่งให้เพื่อนร่วมงาน และแนบในรายงานข้อผิดพลาด ความลับไม่ควรอยู่ที่นั่น
ผลลัพธ์ที่คาดหวัง
การตรวจสอบ: ทำให้เคอร์เซอร์เสียหายด้วยมือในตาราง checkpoint ด้วยคำสั่ง UPDATE checkpoint SET cursor='broken'; และรันตัวโหลด ในคอนโซลควรมีบรรทัดเกี่ยวกับการสลับไปใช้สมอตาม last_id และการดึงข้อมูลดำเนินต่อโดยไม่ล้ม จำนวนระเบียนหลังเสร็จควรตรงกับรอบควบคุมที่ไม่ทำให้เคอร์เซอร์เสีย
ขั้นตอนที่ 7: โครงตัวโหลดข้อมูลที่ทนทานด้วย Python พร้อมใช้งาน
เป้าหมายของขั้นตอนนี้: รวมทุกอย่างจากขั้นตอนก่อนหน้าเป็นไฟล์เดียวที่รันได้ หยุดได้ รันอีกครั้งได้ และได้ผลลัพธ์ครบถ้วนไม่มีข้อมูลซ้ำ
โครงสร้างของ skeleton
- การตั้งค่าจาก environment variable: ที่อยู่พร็อกซี Proxeon, ที่อยู่ API, token, ชื่องาน
- คลาส Store: SQLite ที่มีตาราง records และ checkpoint, transaction หนึ่งต่อหน้า
- ฟังก์ชันคีย์ระเบียนสำหรับ idempotency
- ฟังก์ชันรับหน้าผ่านพร็อกซี
- ลูปหลักพร้อมการทำต่อตามเช็คพอยต์และการสร้างเซสชันใหม่หลังขาดการเชื่อมต่อ
โค้ดเต็ม
# resumable_loader.py
import hashlib
import json
import os
import sqlite3
import time
from datetime import datetime, timezone

import requests

PROXY_URL = os.environ['PROXY_URL']# http://USER:PASS@HOST:PORT из кабинета Proxeon
API_BASE = os.environ.get('API_BASE', 'https://api.example.com')
API_TOKEN = os.environ.get('API_TOKEN', '')
DB_PATH = os.environ.get('DB_PATH', 'export.sqlite')
JOB = os.environ.get('JOB', 'orders-2026')
PAGE_SIZE = 500
MAX_ATTEMPTS = 8
FIELDS = ('cursor', 'last_id', 'pages', 'rows', 'started_at')


def now():
return datetime.now(timezone.utc).isoformat()


def record_key(rec):
canon = json.dumps({'id': rec['id']}, sort_keys=True, separators=(',', ':'))
return hashlib.blake2b(canon.encode('utf-8'), digest_size=16).digest()


class Store:
def __init__(self, path):
self.con = sqlite3.connect(path)
self.con.execute('PRAGMA journal_mode=WAL')
self.con.executescript('''
CREATE TABLE IF NOT EXISTS records(
key BLOB PRIMARY KEY,
payload TEXT NOT NULL,
fetched_at TEXT NOT NULL
) WITHOUT ROWID;
CREATE TABLE IF NOT EXISTS checkpoint(
job TEXT PRIMARY KEY,
cursor TEXT,
last_id TEXT,
pages INTEGER NOT NULL,
rows INTEGER NOT NULL,
started_at TEXT,
updated_at TEXT
);
''')

def load(self, job):
row = self.con.execute(
'SELECT cursor, last_id, pages, rows, started_at FROM checkpoint WHERE job=?',
(job,)).fetchone()
if row is None:
return {'cursor': None, 'last_id': None, 'pages': 0, 'rows': 0, 'started_at': now()}
return dict(zip(FIELDS, row))

def commit_page(self, job, rows, state):
ts = now()
with self.con:
self.con.executemany(
'INSERT OR IGNORE INTO records(key, payload, fetched_at) VALUES (?, ?, ?)',
[(record_key(r), json.dumps(r, ensure_ascii=False), ts) for r in rows])
self.con.execute(
'INSERT INTO checkpoint(job, cursor, last_id, pages, rows, started_at, updated_at) '
'VALUES (?, ?, ?, ?, ?, ?, ?) '
'ON CONFLICT(job) DO UPDATE SET cursor=excluded.cursor, last_id=excluded.last_id, '
'pages=excluded.pages, rows=excluded.rows, updated_at=excluded.updated_at',
(job, state['cursor'], state['last_id'], state['pages'], state['rows'],
 state['started_at'], ts))

def unique_count(self):
return self.con.execute('SELECT count(*) FROM records').fetchone()[0]


def make_session():
s = requests.Session()
s.proxies = {'http': PROXY_URL, 'https': PROXY_URL}
s.headers['User-Agent'] = 'resumable-loader/1.0'
if API_TOKEN:
s.headers['Authorization'] = 'Bearer ' + API_TOKEN
return s


def fetch_page(session, cursor):
params = {'limit': PAGE_SIZE}
if cursor:
params['cursor'] = cursor
r = session.get(API_BASE + '/orders', params=params, timeout=(15, 90))
r.raise_for_status()
body = r.json()
return body['items'], body.get('next_cursor')


def run():
store = Store(DB_PATH)
state = store.load(JOB)
print('старт: страниц %d, строк %d, уникальных в базе %d'
 % (state['pages'], state['rows'], store.unique_count()))
session = make_session()
attempts = 0
while True:
try:
items, next_cursor = fetch_page(session, state['cursor'])
attempts = 0
except (requests.ConnectionError, requests.Timeout, requests.HTTPError) as e:
attempts += 1
if attempts > MAX_ATTEMPTS:
print('попытки исчерпаны, состояние сохранено, запустите снова позже')
raise
print('обрыв (%s), попытка %d из %d' % (type(e).__name__, attempts, MAX_ATTEMPTS))
time.sleep(min(60, 2 ** attempts)) # выбор пауз описан в статье про 429 и ретраи
session = make_session() # новая сессия: соединение через прокси пересоздаётся
continue
if not items:
break
state['pages'] += 1
state['rows'] += len(items)
state['last_id'] = str(items[-1]['id'])
state['cursor'] = next_cursor
store.commit_page(JOB, items, state)
if state['pages'] % 20 == 0:
print('страниц %d, строк %d' % (state['pages'], state['rows']))
if next_cursor is None:
break
print('готово: страниц %d, строк получено %d, уникальных в базе %d'
 % (state['pages'], state['rows'], store.unique_count()))


if __name__ == '__main__':
run()
วิธีปรับให้เข้ากับแหล่งข้อมูลของคุณ
- เปลี่ยน path
/ordersและชื่อฟิลด์items,next_cursor,idเป็นที่ API ของคุณส่งกลับ นี่คือสามจุดในฟังก์ชัน fetch_page และ record_key - ถ้าแหล่งข้อมูลแบ่งหน้าด้วย offset เปลี่ยนพารามิเตอร์ cursor เป็น page และคำนวณค่าถัดไปเป็น state['pages'] + 1 ในเช็คพอยต์เก็บหมายเลขหน้าแทนเคอร์เซอร์
- ถ้าแบ่งหน้าด้วยคีย์ ส่งพารามิเตอร์เช่น
after_idจาก state['last_id'] และลบการทำงานกับเคอร์เซอร์ - ถ้าต้องการขนาน ย้าย fetch_page ไปเป็น fetch_fn จากขั้นตอนที่ 5 และใช้ commit_page เป็น write_fn แบ่งการดึงข้อมูลเป็น shard และเติมคิวงาน
- เพิ่มฟังก์ชัน preflight จากขั้นตอนที่ 6 ก่อนลูปหลัก
การตรวจสอบผลลัพธ์: เช็คลิสต์
ก่อนรันตัวโหลดกับปริมาณจริงหลายชั่วโมง ให้รันผ่านรายการนี้ แต่ละข้อใช้เวลาสองนาที และรวมกันรับประกันว่าการดึงข้อมูลกลางคืนจะไม่สูญเสียข้อมูล
- ทดสอบการขัดจังหวะ รันตัวโหลด หลังจาก 30 วินาทีกด Ctrl+C รันอีกครั้ง บรรทัดแรกของเอาต์พุตควรแสดงจำนวนหน้าที่ไม่ใช่ศูนย์ ไม่ใช่ "หน้า 0"
- ทดสอบข้อมูลซ้ำ ลด PAGE_SIZE เป็น 10 ขัดจังหวะตัวโหลดห้าครั้งติดกันในเวลาสุ่ม เมื่อเสร็จเปรียบเทียบจำนวนระเบียนที่ไม่ซ้ำกับจำนวนแถวทั้งหมด: ที่ไม่ซ้ำควรน้อยกว่าหรือเท่ากัน และสำหรับการแบ่งหน้าด้วยเคอร์เซอร์ที่สะอาดโดยไม่มีการแทรกในแหล่งข้อมูล เกือบเท่ากัน
- ทดสอบความสอดคล้อง หลังการขัดจังหวะใดๆ รันสองคำขอ:
SELECT rows FROM checkpoint;และSELECT count(*) FROM records;ผลต่างไม่ควรเกินหนึ่งขนาดหน้า ถ้าเกิน แสดงว่าเช็คพอยต์และข้อมูลไม่ได้เขียนใน transaction เดียวกัน - ทดสอบพร็อกซี ปิด PROXY_URL ชั่วคราวหรือใส่รหัสผ่านผิด ตัวโหลดควรล้มที่คำขอแรกพร้อมข้อผิดพลาดที่ชัดเจน ไม่ใช่ค้างหรือเริ่มต่อแหล่งข้อมูลโดยตรง
- ทดสอบเคอร์เซอร์หมดอายุ ทำให้เคอร์เซอร์เสียในฐานข้อมูลตามที่อธิบายในขั้นตอนที่ 6 และตรวจว่าการสลับไปใช้สมอทำงาน
- ทดสอบดิสก์ ตรวจขนาดไฟล์ export.sqlite หลังหนึ่งพันหน้าและคูณด้วยจำนวนหน้าที่คาด ตรวจว่าดิสก์มีที่พอโดยเหลือ 20 เปอร์เซ็นต์
การตรวจสอบ: ตัวชี้วัดความสำเร็จคือ หลังการขัดจังหวะโดยเจตนาสามครั้งและการรีสตาร์ทสามครั้ง จำนวนระเบียนที่ไม่ซ้ำทั้งหมดตรงกับจำนวนที่ได้จากการรันต่อเนื่องครั้งเดียวบนแหล่งข้อมูลเดียวกัน และในคอนโซลไม่เคยมีบรรทัดเกี่ยวกับการเริ่มจากศูนย์
ความสามารถเพิ่มเติมและการปรับแต่ง
- ความคืบหน้าและการประเมินเวลา ถ้าทราบจำนวนระเบียนทั้งหมด แสดงเปอร์เซ็นต์และเวลาที่เหลือทุกยี่สิบหน้า มีประโยชน์ทั้งกับคุณและเพื่อแยกการค้างจากการทำงานช้า
- บีบอัด payload สำหรับหลายสิบล้านระเบียน JSON ในรูปแบบข้อความกินที่มาก บีบอัดฟิลด์ payload ด้วย zlib.compress ก่อนเขียนและเก็บเป็น BLOB ประหยัดได้สามถึงแปดเท่า
- ย้ายไปฐานข้อมูลเซิร์ฟเวอร์ รูปแบบเช็คพอยต์ใน transaction เดียวกับข้อมูลย้ายไป PostgreSQL ได้แทบไม่ต้องแก้ โครงสร้าง ON CONFLICT รองรับที่นั่น และข้อจำกัด "ผู้เขียนเดียว" หายไป
- การดึงข้อมูลแบบ incremental เก็บเวลาเริ่มของแต่ละงานและหลังการดึงข้อมูลเต็ม รันงานแยกด้วยฟิลเตอร์ "แก้ไขหลัง" วิธีนี้คุณรักษาสำเนาที่เป็นปัจจุบันโดยไม่ต้องโหลดใหม่ทั้งหมด
- โปรเซสแยกต่อ shard แทน thread สามารถรันหลายอินสแตนซ์ของสคริปต์ด้วยค่า JOB ต่างกันและ DB_PATH ต่างกัน แล้วรวมผลลัพธ์ตอนท้าย ง่ายกว่าในการ debug และขจัดปัญหาการเขียนพร้อมกันทั้งหมด
- เมตริกการขาดการเชื่อมต่อ บันทึกทุกการขาดการเชื่อมต่อพร้อมประเภทข้อยกเว้นและเวลา ผ่านไปหนึ่งวันคุณจะเห็นว่าการขาดเชื่อมต่อกระจุกตัวรอบช่วงเวลาการหมุน IP บนช่องทาง Proxeon และสามารถปรับช่วงการหมุนให้เข้ากับความยาวคำขอของคุณ
ข้อผิดพลาดทั่วไปและวิธีแก้
ด้านล่างรวบรวมสถานการณ์ที่เกือบทุกคนเจอในการรันครั้งแรก รูปแบบ: ปัญหา สาเหตุ วิธีแก้
- ปัญหา: หลังรีสตาร์ท การดึงข้อมูลเริ่มจากศูนย์ทุกครั้ง สาเหตุ: เช็คพอยต์เขียนในหน่วยความจำหรือไฟล์ที่ไม่รอดจากการล้มเหลว หรือตัวโหลดไม่อ่านตอนเริ่ม วิธีแก้: ตรวจว่าการกระทำแรกในฟังก์ชัน run คือ store.load และสถานะอัปเดตหลังทุกหน้าใน transaction
- ปัญหา: ในฐานข้อมูลมีระเบียนมากกว่าหนึ่งเท่าครึ่งของแหล่งข้อมูล สาเหตุ: คีย์การลบข้อมูลซ้ำไม่เสถียร: มีเวลาคำขอ หมายเลขหน้า หรือฟิลด์ที่มีลำดับสุ่ม วิธีแก้: คำนวณคีย์เฉพาะจาก id ของแหล่งข้อมูลหรือจาก list ฟิลด์ที่เสถียรชัดเจนผ่านพารามิเตอร์ fields
- ปัญหา: ในฐานข้อมูลมีระเบียนน้อยกว่าแหล่งข้อมูล แม้การดึงข้อมูลเสร็จไม่มีข้อผิดพลาด สาเหตุ: เช็คพอยต์อัปเดตก่อนเขียนข้อมูล และหลังล้มเหลวหน้าถูกข้าม หรือการแบ่งหน้าด้วย offset เมื่อแหล่งข้อมูลลบระเบียนทำให้หน้าเลื่อนกลับ วิธีแก้: เปลี่ยนลำดับเป็น "ข้อมูลก่อน แล้วเช็คพอยต์" ใน transaction เดียวกัน สำหรับแหล่งข้อมูลที่มีการลบ เปลี่ยนไปใช้การแบ่งหน้าด้วยคีย์
- ปัญหา: การดาวน์โหลดต่อให้ archive เสียหายทั้งที่ขนาดตรง สาเหตุ: เซิร์ฟเวอร์ตอบ 200 แทน 206 ครั้งหนึ่ง ไฟล์ถูกเขียนทับบางส่วน แล้วต่อท้าย วิธีแก้: เก็บ ETag ข้างไฟล์ ลบไฟล์เมื่อเปลี่ยน ตรวจ header Content-Range ให้ตรงกับ offset ที่ขอ
- ปัญหา: ข้อผิดพลาด "database is locked" ระหว่างทำงานขนาน สาเหตุ: หลาย thread เขียน SQLite พร้อมกันหรือ connection ถูกส่งระหว่าง thread วิธีแก้: จุดเขียนเดียวใน main thread worker แค่ดาวน์โหลด โหมด WAL connection สร้างใน thread ที่ใช้
- ปัญหา: หลังทำงานหนึ่งชั่วโมง ทุกคำขอเริ่มคืน 401 สาเหตุ: access token หมดอายุ วิธีแก้: อัปเดต token ตามตารางก่อนหมดอายุ และเมื่อได้ 401 ให้เรียกอัปเดตและลองคำขออีกครั้งหนึ่ง ไม่นับเป็นการขาดการเชื่อมต่อ
- ปัญหา: RAM เพิ่มขึ้นถึงหลาย gigabyte สาเหตุ: set ของคีย์ที่เห็นแล้วหรือ list ของระเบียนทั้งหมดถูกเก็บในหน่วยความจำของโปรเซส วิธีแก้: ลบข้อมูลซ้ำผ่าน primary key ในฐานข้อมูลหรือตาราง seen เขียนข้อมูลแบบแบ่งหน้า ไม่สะสม
- ปัญหา: การขาดการเชื่อมต่อเกิดทุกสองสามนาทีพอดี สาเหตุ: ตรงกับช่วงการหมุน IP ของช่องทางพร็อกซี วิธีแก้: นี่คือสถานการณ์ปกติ ตัวโหลดต้องรอด ถ้าคำขอยาว ปรับช่วงการหมุนในแดชบอร์ด Proxeon ให้มากกว่าเวลาคำขอทั่วไปอย่างชัดเจน หรือใช้การหมุนตามคำขอระหว่างหน้า
FAQ: คำถามที่พบบ่อยเกี่ยวกับการดึงข้อมูลที่ทนทาน
จำเป็นต้องใช้ SQLite ถ้าผลลัพธ์ต้องเป็น CSV หรือไม่
ไม่ แต่สะดวก SQLite ที่นี่ทำหน้าที่เป็นที่เก็บสถานะที่เชื่อถือได้และ set ของคีย์ที่เห็นแล้ว CSV สุดท้ายคุณส่งออกด้วยคำสั่งเดียวจากตาราง records หลังเสร็จ ถ้าไม่อยากใช้ฐานข้อมูลเลย ใช้ทางเลือกไฟล์จากขั้นตอนที่ 3 ด้วยหนึ่งไฟล์ต่อหน้าและเช็คพอยต์ JSON พร้อมการแทนที่แบบ atomic
บันทึกเช็คพอยต์บ่อยแค่ไหน: ทุกหน้าหรือน้อยกว่า
ทุกหน้า transaction SQLite หนึ่งครั้งกับไม่กี่ร้อยแถวใช้เวลาไม่กี่มิลลิวินาที น้อยมากเมื่อเทียบกับคำขอเครือข่ายผ่านพร็อกซี การประหยัดด้วยเช็คพอยต์ที่ห่างไม่คุ้มกับความเสี่ยงที่จะสูญเสียหลายสิบหน้า
จะทำอย่างไรถ้า API ไม่ส่งทั้งเคอร์เซอร์และ id มีแค่หมายเลขหน้า
ทำงานด้วยหมายเลขหน้า เก็บในเช็คพอยต์ และต้องเปิดการลบข้อมูลซ้ำด้วย hash ของเนื้อหาระเบียน ยอมรับว่าถ้าการเปลี่ยนในแหล่งข้อมูลแอคทีฟ ส่วนหนึ่งของระเบียนอาจถูกข้ามเนื่องจากหน้าเลื่อน สำหรับข้อมูลสำคัญ ทำรอบที่สองในลำดับหน้าย้อนกลับ: ส่วนที่ข้ามในรอบแรกมีโอกาสสูงที่จะอยู่ในรอบที่สอง
ดาวน์โหลดต่อไฟล์ด้วยหลาย thread ในช่วงต่างๆ กันได้ไหม
ได้ถ้าเซิร์ฟเวอร์รองรับ Range แบ่งไฟล์เป็นส่วนๆ ละ 50-100 MB แต่ละส่วนเป็นงานจากคิวในขั้นตอนที่ 5 พร้อมไฟล์ชั่วคราวของตัวเอง และเมื่อทุกส่วนเสร็จต่อเข้าด้วยกันตามลำดับ ตรวจแต่ละส่วนด้วยขนาด และทั้งไฟล์ด้วย checksum ถ้ามี
ควรใช้กี่ worker เมื่อทำงานผ่านพร็อกซี
เริ่มด้วยสามถึงสี่ต่อหนึ่งช่องทาง Proxeon และสังเกตอัตราข้อผิดพลาดในตาราง tasks ถ้าข้อผิดพลาดน้อยกว่าหนึ่งเปอร์เซ็นต์ เพิ่มอีกสอง ถ้าข้อผิดพลาดเพิ่ม ลดลง มากกว่าสิบ thread ต่อหนึ่งช่องทาง rarely ให้ผลตอบแทน: ติดที่แบนด์วิดท์ของช่องทางหรือความอดทนของแหล่งข้อมูล
จำเป็นต้องบันทึก cookies เซสชันระหว่างการรันหรือไม่
ปกติไม่ การรับรองใหม่ตอนเริ่มใช้เวลาไม่กี่วินาทีและเชื่อถือได้มากกว่าการกู้คืน cookies ที่อายุไม่แน่นอน ข้อยกเว้น: แหล่งข้อมูลจำกัดจำนวนการเข้าสู่ระบบต่อวัน แล้วเก็บ cookies แต่เมื่อเจอ 401 หรือ redirect ไปหน้า login ครั้งแรก ให้ทิ้งและรับรองใหม่
จะรู้ได้อย่างไรว่าการดึงข้อมูลเสร็จสมบูรณ์ ไม่ได้ขาดเงียบๆ
สำหรับไฟล์: ขนาดเท่ากับ Content-Length และ checksum ตรง สำหรับ API: ได้หน้าที่ยังไม่มี next_cursor หรือหน้าว่าง และจำนวนแถวตรงกับจำนวนทั้งหมด ถ้าแหล่งข้อมูลรายงาน บันทึก flag การเสร็จสิ้นชัดเจนในเช็คพอยต์ เพื่อการรันซ้ำจะไม่เริ่มการสำรวจใหม่
ทำอย่างไรกับงานที่มีสถานะ failed
ดูฟิลด์ last_error ถ้าเป็นข้อผิดพลาดเครือข่าย เพียงเปลี่ยนงานกลับเป็น pending ด้วยคำสั่ง UPDATE และรันตัวโหลดอีกครั้ง ถ้าเป็นข้อผิดพลาดในการ parse ข้อมูล แสดงว่ามีระเบียนรูปแบบไม่มาตรฐานในแหล่งข้อมูล: แก้โค้ดและรีสตาร์ท อย่าลบ failed เงียบๆ นี่คือหลักฐานเดียวของสิ่งที่ขาดในการดึงข้อมูล
ใช้แนวทางนี้กับไลบรารี async พร้อม requests ได้ไหม
ได้ หลักการเหมือนกัน: หน่วยงาน atomic เช็คพอยต์พร้อมข้อมูล การเขียนแบบ idempotent คิวบนดิสก์ เปลี่ยนแค่ transport ข้อเดียว: การเขียน SQLite ให้คงเป็น synchronous และตามลำดับ และขนานที่ระดับคำขอเครือข่าย
บทสรุป
คุณเดินทางจากไฟล์ไม่สมบูรณ์และการรีสตาร์ทด้วยความกังวล ไปจนถึงตัวโหลดที่การขาดการเชื่อมต่อไม่มีความหมาย มาสรุปสิ่งที่ทำไปแล้ว
- เข้าใจการดาวน์โหลดต่อผ่าน HTTP: ตรวจ Accept-Ranges ผ่าน HEAD, header Range ด้วยขนาดไฟล์ปัจจุบัน, แยกแยะรหัส 206 และ 200, ป้องกันการเปลี่ยนไฟล์ผ่าน ETag และ If-Range
- สร้างเช็คพอยต์สำหรับการดึงข้อมูลแบบแบ่งหน้า: เคอร์เซอร์ หมายเลขหน้า หรือ id ของระเบียนสุดท้าย บวกตัวนับบริการ ทั้งหมดใน transaction เดียวกับข้อมูล
- ทำให้การเขียน idempotent ผ่าน primary key และโครงสร้าง INSERT OR IGNORE หรือ ON CONFLICT DO UPDATE และสำหรับไฟล์ผ่านชื่อ deterministic และการแทนที่แบบ atomic
- จัดการลบข้อมูลซ้ำบนดิสก์ เพื่อให้หลายล้านคีย์ไม่อยู่ใน RAM และรอดจากการรีสตาร์ท
- เพิ่มการทำงานแบบขนานพร้อมคิวงานใน SQLite การคืนงานที่ล้มเหลวอัตโนมัติ และจุดเขียนเดียว
- วางแผนการทำต่อหลังหยุดพักนาน: อัปเดต token รับรองใหม่ สลับจากเคอร์เซอร์ที่หมดอายุไปใช้สมอตาม id ตรวจพร็อกซี Proxeon ก่อนเริ่ม
- รวมทุกอย่างเป็น skeleton ที่ใช้งานได้ ซึ่งปรับให้เข้ากับแหล่งข้อมูลเฉพาะด้วยการเปลี่ยนสามถึงสี่บรรทัด
ทำอะไรต่อไป
นำ skeleton จากขั้นตอนที่ 7 ไปรันกับปริมาณจริงเล็กๆ เช่นหนึ่งหมื่นระเบียน รันเช็คลิสต์จากการตรวจสอบก่อน จากนั้นค่อยรันการดึงข้อมูลเต็มในตอนกลางคืน เช้าวันรุ่งขึ้นคุณจะเห็นบรรทัด "เสร็จสิ้น" พร้อมตัวนับตรงกัน หรือบรรทัดเกี่ยวกับความพยายามที่หมดพร้อมสถานะที่บันทึกไว้ แล้วแค่รันสคริปต์อีกครั้ง
จะพัฒนาต่อไปไหน
ระดับถัดไปคือการดึงข้อมูลแบบ incremental ตามเวลาที่แก้ไขแทนการสำรวจเต็มรูปแบบ การย้ายสถานะไปยังฐานข้อมูลเซิร์ฟเวอร์สำหรับหลายเครื่อง และกลยุทธ์การลองซ้ำที่มีความหมายโดยคำนึงถึง status code ซึ่งมีบทความแยกเกี่ยวกับ 429 และการลองซ้ำ การรวมการลองซ้ำที่เหมาะสมจากบทความนั้นกับสถานะที่ทนทานจากบทนี้ให้ตัวโหลดที่ปล่อยทิ้งไว้ทำงานได้หนึ่งสัปดาห์โดยไม่ต้องเปิดเทอร์มินัล
และสุดท้าย การขาดการเชื่อมต่อของการดึงข้อมูลยาวนานไม่ใช่เหตุฉุกเฉิน แต่เป็นสถานการณ์ปกติที่คุณจัดการได้แล้ว ขอให้ดึงข้อมูลราบรื่น