Как выгружать большие объёмы данных через прокси без перезапуска с нуля после обрыва: пошаговый гайд
Содержание статьи
- Введение: почему длинная выгрузка почти всегда обрывается, и это нормально
- Предварительная подготовка и базовые понятия
- Шаг 1: докачка файла по http через заголовок range
- Шаг 2: чекпоинты для постраничных выгрузок
- Шаг 3: идемпотентность записи результатов
- Шаг 4: дедупликация результатов без раздувания памяти
- Шаг 5: параллелизм без потерь
- Шаг 6: возобновление после долгого перерыва
- Шаг 7: готовый скелет устойчивого загрузчика на python
- Типичные ошибки и решения
- Faq: частые вопросы по устойчивой выгрузке
- Заключение
Введение: почему длинная выгрузка почти всегда обрывается, и это нормально
Если вы хоть раз выгружали через прокси несколько миллионов записей или файл на десятки гигабайт, вы знакомы с этим чувством. Скрипт работал шесть часов, показывал 83 процента, а потом упал с ошибкой соединения. И всё, что у вас есть, это неполный файл и понимание, что придётся начинать сначала.
Первое, что нужно принять: длинная выгрузка обрывается всегда. Не «иногда», не «при плохой сети», а всегда, если она длится достаточно долго. Причин десятки, и большинство из них вне вашего контроля:
- Прокси меняет внешний IP-адрес. У мобильных прокси Proxeon это штатное поведение: ротация по таймеру или по запросу. В момент смены IP открытое TCP-соединение разрывается, и сервер источника видит уже другого клиента.
- Сервер источника закрывает соединение по своему таймауту, перезагружается, выкатывает обновление или просто отвечает ошибкой 5xx.
- Ваш собственный процесс перезапускается: обновление системы, переполнение диска, ошибка в коде на нетипичной записи, случайный Ctrl+C.
- Протухает токен авторизации, истекает сессия, устаревает курсор постраничной выгрузки.
- Ноутбук уходит в сон, Wi-Fi переключается на другую точку, провайдер меняет маршрут.
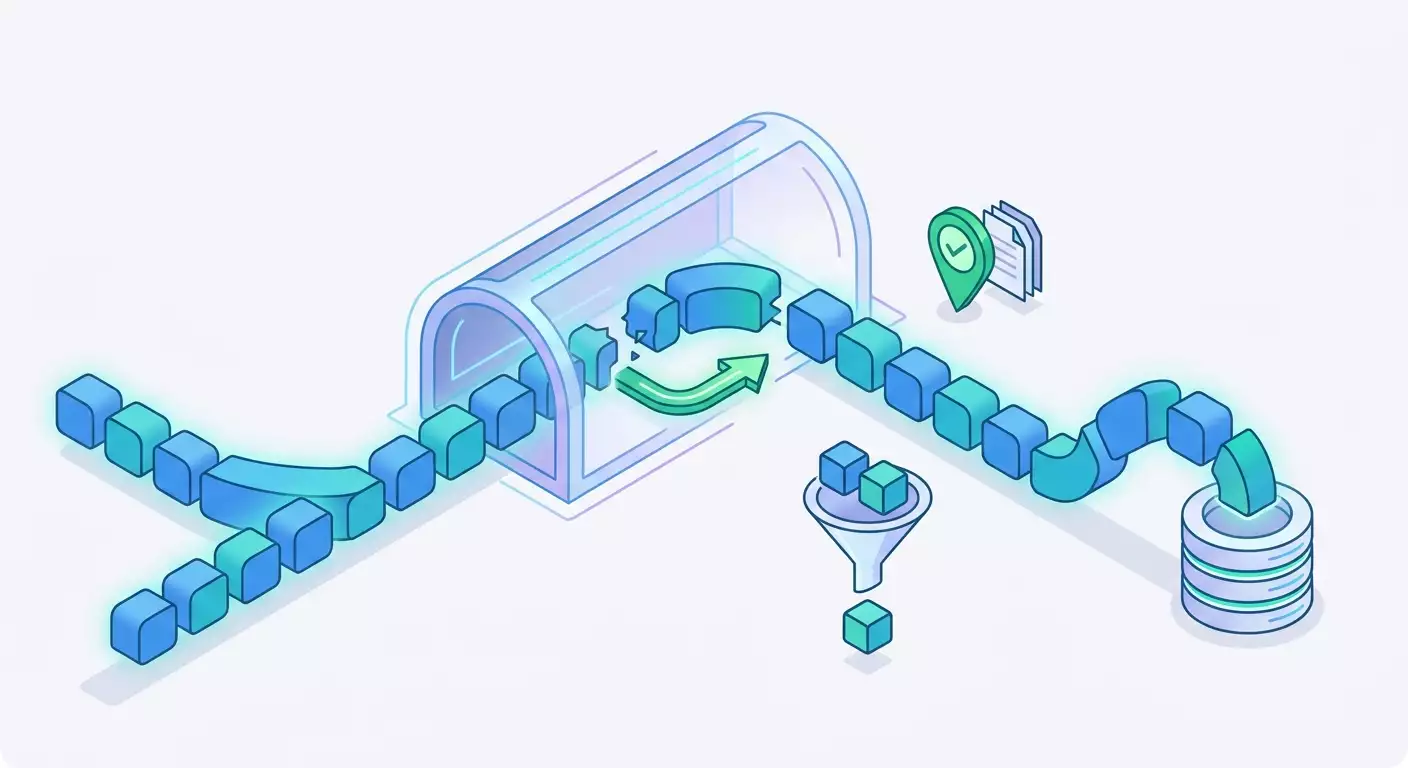
Бороться с каждой из этих причин по отдельности бессмысленно. Правильный подход другой: спроектировать выгрузку так, чтобы обрыв в любой момент стоил вам не шести часов, а одной страницы или одного куска файла. Именно этому посвящён гайд.
Что вы получите в итоге
После прохождения инструкции у вас будет:
- Рабочая функция докачки файла с середины по протоколу HTTP через заголовок Range с проверкой, что сервер это поддерживает.
- Понятная схема чекпоинтов для постраничных выгрузок: что именно сохранять и где хранить состояние, чтобы оно не потерялось вместе с процессом.
- Идемпотентная запись результатов, при которой повторная загрузка той же страницы не создаёт дублей.
- Дедупликация, которая не съедает всю оперативную память на миллионах строк.
- Параллельный загрузчик с очередью заданий, повтором упавших задач и ограничением одновременности.
- Готовый скелет устойчивого загрузчика на Python, который вы адаптируете под свой источник за час.
Для кого этот гайд
Для разработчиков и аналитиков, которые уже умеют делать HTTP-запросы из Python и хотя бы раз теряли результаты долгой выгрузки. Уровень средний: базовые вещи объясняем, но не учим программировать с нуля. Продвинутые читатели найдут разделы про хранение хешей вне памяти и про безопасную параллельную запись в SQLite.
Что нужно знать заранее
- Python на уровне функций, циклов, словарей и обработки исключений.
- Основы HTTP: что такое метод, заголовок, код ответа, тело.
- Общее представление о том, как задать прокси в библиотеке requests.
Отдельно оговоримся: коды ответа и стратегии повторов с экспоненциальной паузой здесь не разбираем. Этому посвящена отдельная статья про ошибку 429 и ретраи. В этом гайде фокус на другом: на состоянии выгрузки и её возобновлении. Ретраи отвечают на вопрос «когда повторить запрос», а мы отвечаем на вопрос «с какого места продолжить работу после того, как повторы исчерпаны и процесс умер».
Сколько времени потребуется
Чтение и запуск примеров на тестовом источнике: два-три часа. Адаптация скелета под ваш реальный API или файловый сервер: ещё один-два часа в зависимости от того, насколько нестандартна пагинация. Итого рабочий день с запасом.
Предварительная подготовка и базовые понятия
Инструменты и доступы
- Установите Python версии 3.11 или новее. В 2026 году актуальны ветки 3.12 и 3.13, все примеры проверены на них. Проверить версию: откройте терминал и введите
python --version. Если увидите 3.11 или выше, всё в порядке. - Установите библиотеку requests:
pip install requests. Достаточно версии 2.32 и новее. Модуль sqlite3 входит в стандартную библиотеку Python, ставить отдельно ничего не нужно. - Получите доступ к прокси. Откройте личный кабинет Proxeon, выберите нужный канал и скопируйте четыре значения: хост, порт, логин и пароль. Обычно они собраны в одну строку вида
http://USER:PASS@HOST:PORT. Эту строку вы будете использовать везде далее. - Положите строку прокси в переменную окружения, а не в код. В Linux и macOS:
export PROXY_URL=http://USER:PASS@HOST:PORT. В Windows PowerShell:$env:PROXY_URL='http://USER:PASS@HOST:PORT'. Так вы не закоммитите пароль в репозиторий случайно. - Проверьте, что прокси отвечает. Выполните в терминале:
curl -x $PROXY_URL -I https://api.example.com/, подставив адрес вашего источника. Вы должны увидеть строку с кодом ответа, напримерHTTP/2 200. Если видите ошибку авторизации прокси 407, перепроверьте логин и пароль.
Системные требования
Любая машина с 2 ГБ свободной оперативной памяти и диском, на котором помещается результат выгрузки плюс 20 процентов запаса под индексы SQLite. Если вы планируете загружать миллионы записей, диск важнее памяти: весь подход построен на том, что состояние живёт на диске, а не в переменных процесса.
Резервные копии
Файл состояния, который вы создадите ниже (в примерах это export.sqlite), станет самым ценным артефактом всей работы. Заведите привычку копировать его перед любыми экспериментами с кодом: cp export.sqlite export.sqlite.bak. Один раз это спасёт вам сутки выгрузки.
Внимание: никогда не редактируйте файл SQLite вручную во время работы загрузчика. Даже чтение из сторонней программы в неправильном режиме может заблокировать запись и уронить процесс. Если нужно посмотреть состояние, остановите загрузчик или используйте режим WAL, о котором расскажем в разделе про параллелизм.
Ключевые термины простым языком
- Чекпоинт — сохранённая на диске отметка «до этого места всё выгружено и записано». После обрыва загрузчик читает чекпоинт и продолжает с него.
- Курсор — непрозрачная строка, которую API отдаёт вместе со страницей и которую нужно передать, чтобы получить следующую страницу. Сами вы курсор не составляете и не разбираете.
- Постраничная выгрузка по смещению — когда вы просите «страницу 37 по 500 записей». Простая схема, но при добавлении новых записей в источник страницы сдвигаются и появляются дубли или пропуски.
- Постраничная выгрузка по ключу (keyset) — когда вы просите «всё с идентификатором больше 184203, отсортированное по идентификатору». Самая устойчивая схема для возобновления, если источник её поддерживает.
- Идемпотентность — свойство операции, при котором её повторное выполнение даёт тот же результат, что и однократное. Записали страницу дважды, а в базе она лежит один раз.
- Ключ дедупликации — значение, по которому две записи считаются одной и той же. Идеально, если это идентификатор из источника; если его нет, ключ вычисляется как хеш стабильных полей.
- Заголовок Range — способ попросить HTTP-сервер отдать не весь файл, а его часть, например байты с 1048576 до конца.
- Семантика at-least-once — гарантия, что каждая запись будет получена хотя бы один раз. Возможны повторы, но не пропуски. Именно её вы получите после этого гайда, а дубли уберёт дедупликация.
Главный принцип
Все семь шагов ниже сводятся к одной идее: каждая единица работы должна быть атомарной и повторяемой. Единица работы — это либо кусок файла, либо страница API, либо задание из очереди. Атомарной — значит, результат и отметка о его завершении сохраняются вместе. Повторяемой — значит, если единицу выполнить дважды, ничего не сломается. Когда оба свойства выполнены, обрыв в любой точке становится безопасным.
Шаг 1: Докачка файла по HTTP через заголовок Range
Цель этапа: научиться скачивать большой файл через прокси так, чтобы после обрыва загрузка продолжалась с того байта, на котором остановилась, а не с нуля.
Как это работает
Протокол HTTP позволяет клиенту запросить часть ресурса. Для этого в запрос добавляется заголовок Range: bytes=НАЧАЛО-, где НАЧАЛО — это смещение в байтах. Если сервер поддерживает частичные запросы, он отвечает кодом 206 Partial Content и заголовком Content-Range: bytes НАЧАЛО-КОНЕЦ/ВСЕГО. Если не поддерживает, он проигнорирует Range и отдаст весь файл с кодом 200. Ваша задача различать эти случаи.
Заранее узнать, поддерживает ли сервер докачку, помогает запрос HEAD: он возвращает только заголовки без тела. Смотрите на Accept-Ranges: bytes. Значение none или отсутствие заголовка обычно означает, что докачки нет, хотя некоторые серверы всё равно обрабатывают Range корректно, поэтому финальную проверку делаем по коду ответа.
Пошаговая инструкция
- Сделайте HEAD-запрос через прокси и сохраните заголовки Accept-Ranges, Content-Length, ETag и Last-Modified. ETag понадобится, чтобы понять, не изменился ли файл на сервере между вашими попытками.
- Посмотрите, сколько байт уже лежит в локальном файле. Если файла нет, считайте, что ноль.
- Если локальный размер уже равен Content-Length, файл полный, ничего делать не нужно.
- Если локальный размер больше нуля и сервер заявляет поддержку диапазонов, добавьте в запрос заголовок Range с текущим размером. Добавьте также
If-Rangeс сохранённым ETag: тогда сервер отдаст частичный ответ только если файл не менялся, а иначе вернёт весь файл целиком с кодом 200. - Обязательно отправьте
Accept-Encoding: identity. Без него сервер может применить сжатие на лету, и байтовые смещения перестанут совпадать с вашим файлом. - Откройте локальный файл в режиме дозаписи
ab, если получили 206, или в режиме перезаписиwb, если получили 200. - Читайте тело потоком кусками по 256 КБ и записывайте на диск. Не загружайте весь ответ в память.
- После завершения сравните итоговый размер с Content-Length. Если не совпадает, значит соединение оборвалось тихо, и нужен ещё один заход.
Рабочий код
import os
import requests

PROXY_URL = os.environ['PROXY_URL'] # строка из личного кабинета Proxeon
PROXIES = {'http': PROXY_URL, 'https': PROXY_URL}


def probe(url):
r = requests.head(url, proxies=PROXIES, allow_redirects=True, timeout=30,
 headers={'Accept-Encoding': 'identity'})
r.raise_for_status()
return {
'ranges': r.headers.get('Accept-Ranges', 'none').lower(),
'length': int(r.headers.get('Content-Length', 0) or 0),
'etag': r.headers.get('ETag'),
}


def download_resumable(url, path):
meta = probe(url)
have = os.path.getsize(path) if os.path.exists(path) else 0
if meta['length'] and have >= meta['length']:
print('файл уже полный:', have, 'байт')
return True
headers = {'Accept-Encoding': 'identity'}
if have > 0 and meta['ranges'] == 'bytes':
headers['Range'] = 'bytes=%d-' % have
if meta['etag']:
headers['If-Range'] = meta['etag']
with requests.get(url, headers=headers, proxies=PROXIES, stream=True,
 timeout=(30, 120)) as r:
if r.status_code == 206:
expected = 'bytes %d-' % have
if not r.headers.get('Content-Range', '').startswith(expected):
raise IOError('сервер отдал не тот диапазон: ' + r.headers.get('Content-Range', ''))
mode = 'ab'
elif r.status_code == 200:
print('сервер отдаёт файл целиком, начинаем с нуля')
mode = 'wb'
have = 0
elif r.status_code == 416:
raise IOError('запрошенный диапазон вне файла, проверьте локальный размер')
else:
r.raise_for_status()
with open(path, mode) as f:
for chunk in r.iter_content(chunk_size=256 * 1024):
if chunk:
f.write(chunk)
have += len(chunk)
if meta['length'] and have != meta['length']:
print('обрыв: получено %d из %d' % (have, meta['length']))
return False
return True


def download_until_done(url, path, max_rounds=50):
for i in range(max_rounds):
try:
if download_resumable(url, path):
return
except (requests.ConnectionError, requests.Timeout, IOError) as e:
print('заход %d прерван: %s' % (i + 1, type(e).__name__))
# пауза перед следующим заходом: стратегия описана в статье про 429 и ретраи
raise RuntimeError('не удалось докачать файл за %d заходов' % max_rounds)


if __name__ == '__main__':
download_until_done('https://files.example.com/export-2026.csv.gz', 'export-2026.csv.gz')
Обратите внимание на функцию download_until_done: она не содержит логики ожидания между попытками. Это сделано намеренно. Вставьте туда свою стратегию пауз из статьи про ретраи, здесь важен только цикл «проверил размер, докачал, проверил снова».
Совет: если файл раздаётся в виде архива, не распаковывайте его на лету во время докачки. Сначала получите полный файл, проверьте размер и, если сервер отдаёт контрольную сумму, сверьте её. Только потом распаковывайте. Частично скачанный gzip выглядит как повреждённый, и вы потратите время на поиск несуществующей ошибки.
Ожидаемый результат
Проверка: запустите скрипт на файле размером хотя бы 200 МБ, через десять секунд прервите его сочетанием Ctrl+C. Посмотрите размер локального файла, например 41 943 040 байт. Запустите скрипт снова. В консоли не должно появиться строки «начинаем с нуля», а размер файла должен расти дальше, а не сбрасываться. По завершении итоговый размер должен точно совпасть с Content-Length из HEAD-запроса.
Возможные проблемы
- Сервер всегда отдаёт 200 вместо 206. Значит, докачка не поддерживается. Единственный выход для такого источника — скачивать файл целиком за один заход с большим таймаутом или искать у источника альтернативный формат выгрузки по частям, например разбивку по датам.
- Нет заголовка Content-Length. Сервер отдаёт файл в режиме chunked без объявления размера. Проверять полноту по размеру нельзя, докачивать тоже: Range требует известных смещений. Договоритесь с источником или используйте контрольную сумму, если она публикуется.
- Ответ 416 при первом же заходе. Локальный файл больше, чем файл на сервере. Файл на сервере изменился и стал короче. Удалите локальный файл и начните заново.
- Размер совпал, но файл битый. Скорее всего, где-то в середине был обрыв с кодом 200 и записью с нуля, а потом дозапись. Пересоздайте файл. Чтобы такого не повторялось, храните ETag в отдельном файле рядом и сравнивайте перед каждым заходом.
Шаг 2: Чекпоинты для постраничных выгрузок
Цель этапа: сохранять состояние выгрузки так, чтобы после любого падения процесс продолжил с последней успешно записанной страницы.
Что сохранять
Минимальный чекпоинт зависит от типа пагинации у источника. Разберём три случая.
- Пагинация по курсору. API отдаёт вместе с данными поле вроде
next_cursor. Сохраняйте именно его. Это самый простой случай: курсор уже содержит всё, что нужно серверу для продолжения. - Пагинация по номеру страницы или смещению. Сохраняйте номер последней полностью записанной страницы и размер страницы. Помните, что при добавлении записей в источник во время выгрузки смещения сдвигаются, поэтому дедупликация из шага 4 обязательна.
- Пагинация по ключу. Сохраняйте идентификатор последней записанной записи. При возобновлении запрашиваете всё, что больше этого идентификатора. Схема не боится ни вставок, ни долгих пауз.
Независимо от типа пагинации в чекпоинт стоит добавить служебные поля: идентификатор последней записи (даже для курсорной схемы, это запасной якорь на случай, если курсор протухнет), счётчики страниц и строк для контроля прогресса, время старта выгрузки и время последнего обновления.
Где хранить состояние
Есть два рабочих варианта, и оба лучше, чем переменные в памяти.
Вариант А: JSON-файл с атомарной заменой
Подходит, если результаты пишутся в отдельные файлы, а не в базу. Главная ловушка: если писать состояние прямо в целевой файл и процесс упадёт посреди записи, вы получите обрезанный JSON, который не прочитается. Решение — писать во временный файл рядом и переименовывать его поверх основного. Операция переименования в одной файловой системе атомарна.
import json
import os
import tempfile


def save_state(path, state):
directory = os.path.dirname(os.path.abspath(path))
fd, tmp = tempfile.mkstemp(dir=directory, prefix='.state-')
with os.fdopen(fd, 'w', encoding='utf-8') as f:
json.dump(state, f, ensure_ascii=False)
f.flush()
os.fsync(f.fileno())
os.replace(tmp, path)


def load_state(path, default):
if not os.path.exists(path):
return dict(default)
with open(path, encoding='utf-8') as f:
return json.load(f)
Вариант Б: таблица в SQLite рядом с данными
Предпочтительный вариант, если вы складываете записи в базу. Чекпоинт обновляется в той же транзакции, что и вставка строк страницы. Либо записались и данные, и отметка, либо ничего. Разрыва между «данные есть, отметки нет» не бывает в принципе.
import sqlite3

con = sqlite3.connect('export.sqlite')
con.executescript('''
CREATE TABLE IF NOT EXISTS records(
id TEXT PRIMARY KEY,
payload TEXT NOT NULL,
fetched_at TEXT NOT NULL
);
CREATE TABLE IF NOT EXISTS checkpoint(
job TEXT PRIMARY KEY,
cursor TEXT,
last_id TEXT,
pages INTEGER NOT NULL DEFAULT 0,
updated_at TEXT
);
''')


def commit_page(job, rows, next_cursor, pages, ts):
with con: # одна транзакция на страницу
con.executemany(
'INSERT OR IGNORE INTO records(id, payload, fetched_at) VALUES (?, ?, ?)',
[(str(r['id']), json.dumps(r, ensure_ascii=False), ts) for r in rows])
con.execute(
'INSERT INTO checkpoint(job, cursor, last_id, pages, updated_at) VALUES (?, ?, ?, ?, ?) '
'ON CONFLICT(job) DO UPDATE SET cursor=excluded.cursor, last_id=excluded.last_id, '
'pages=excluded.pages, updated_at=excluded.updated_at',
(job, next_cursor, str(rows[-1]['id']), pages, ts))
Порядок операций
Запомните правило: сначала данные, потом чекпоинт, и желательно в одной транзакции. Если транзакция недоступна (например, данные пишутся в файлы), порядок именно такой: записали файл страницы, синхронизировали на диск, затем обновили состояние. При падении между этими двумя действиями вы получите повторную загрузку одной страницы, а это безопасно благодаря шагу 3. Обратный порядок даст пропуск страницы, а это уже потеря данных.
Совет: храните в чекпоинте не текущий курсор, а курсор следующей страницы, который вернул сервер. Тогда при возобновлении вы сразу запрашиваете то, чего у вас ещё нет, без лишнего запроса уже полученной страницы.
Ожидаемый результат
Проверка: запустите выгрузку, дождитесь десяти страниц и завершите процесс принудительно. Откройте базу командой sqlite3 export.sqlite и выполните SELECT pages, last_id FROM checkpoint;. Вы должны увидеть число 10 и идентификатор. Затем выполните SELECT count(*) FROM records; и убедитесь, что количество записей равно десяти размерам страницы. Запустите загрузчик снова: первым сообщением в консоли должно быть что-то вроде «старт: страниц 10».
Возможные проблемы
- Ошибка «database is locked». Другой процесс держит соединение. Закройте все окна sqlite3 и другие инструменты, которые открывали файл. Для многопоточной работы включите режим WAL, см. шаг 5.
- Курсор сохранился, а данные нет. Вы обновили чекпоинт вне транзакции с данными. Вернитесь к коду выше и убедитесь, что обе операции внутри одного блока
with con:. - JSON состояния оказался пустым или битым. Вы писали напрямую в файл без временного файла и замены. Используйте функцию save_state целиком.
Шаг 3: Идемпотентность записи результатов
Цель этапа: сделать так, чтобы повторная обработка любой страницы не порождала дублей и не ломала данные.
Почему повтор неизбежен
После шага 2 вы уже видели сценарий, где страница записывается дважды: процесс упал после вставки данных, но до обновления чекпоинта. Кроме этого, повторы приходят из пагинации по смещению при изменении источника, из параллельных воркеров, которые получили одно и то же задание после рестарта, и просто из ручного перезапуска «на всякий случай». Бороться с повторами на стороне запроса бесполезно. Правильно сделать саму запись такой, чтобы повтор был безвреден.
Выбор ключа дедупликации
- Есть идентификатор у источника. Используйте его. Это поле
id,uuid,order_numberили похожее, которое источник гарантирует уникальным. Если выгружаете из нескольких источников в одну таблицу, делайте составной ключ: имя источника плюс идентификатор. - Идентификатора нет, но есть набор полей, которые вместе определяют запись. Например, для строки прайс-листа это артикул плюс склад плюс дата. Составьте ключ из этих полей, нормализовав их: приведите строки к одному регистру, уберите пробелы по краям, даты переведите в единый формат.
- Ничего стабильного нет. Тогда ключом становится хеш всей записи после канонизации. Подробно этот случай разобран в шаге 4. Учтите, что если источник меняет запись (обновляет цену), хеш изменится, и вы получите обе версии. Иногда это именно то, что нужно, иногда нет.
Внимание: не используйте в качестве ключа порядковый номер строки в ответе или номер страницы. Эти значения меняются при любом изменении источника, и дедупликация превратится в генератор дублей.
Идемпотентная вставка в базу
В SQLite и большинстве реляционных баз есть конструкция, которая либо игнорирует конфликт по первичному ключу, либо обновляет существующую строку. Первый вариант INSERT OR IGNORE вы уже видели в шаге 2. Он подходит, когда записи неизменны. Второй вариант нужен, если источник может обновлять записи и вам нужна свежая версия:
def upsert_rows(con, rows, ts):
con.executemany(
'INSERT INTO records(id, payload, fetched_at) VALUES (?, ?, ?) '
'ON CONFLICT(id) DO UPDATE SET payload=excluded.payload, fetched_at=excluded.fetched_at',
[(str(r['id']), json.dumps(r, ensure_ascii=False), ts) for r in rows])
Идемпотентная запись в файлы
Если результат должен лежать в файлах, а не в базе, применяйте тот же принцип: одна страница равна одному файлу с детерминированным именем. Имя зависит от параметров страницы, а не от времени или счётчика. Перед загрузкой проверяете, существует ли финальный файл; если да, страницу пропускаете. Пишете во временное имя и переименовываете по завершении, как в функции save_state.
def page_path(base_dir, job, cursor_or_page):
safe = str(cursor_or_page).replace('/', '_').replace(':', '_')[:120]
return os.path.join(base_dir, job, 'page-%s.jsonl' % safe)


def write_page_idempotent(path, rows):
if os.path.exists(path):
return False # страница уже есть, повторная запись не нужна
os.makedirs(os.path.dirname(path), exist_ok=True)
tmp = path + '.part'
with open(tmp, 'w', encoding='utf-8') as f:
for r in rows:
f.write(json.dumps(r, ensure_ascii=False))
f.write(chr(10))
f.flush()
os.fsync(f.fileno())
os.replace(tmp, path)
return True
Файлы с расширением .part, оставшиеся после падения, можно смело удалять при старте: они по определению неполные.
Совет: для выгрузки по смещению не полагайтесь только на «файл существует, значит страница готова». Дополнительно проверяйте, что число строк в файле равно размеру страницы (кроме последней). Пустой или короткий файл при существующем имени лучше перезакачать.
Ожидаемый результат
Проверка: вызовите функцию записи одной и той же страницы три раза подряд. Затем выполните SELECT count(*) FROM records;. Число должно равняться размеру одной страницы, а не утроенному. Для файлового варианта в каталоге должен быть ровно один файл страницы и ни одного файла .part.
Шаг 4: Дедупликация результатов без раздувания памяти
Цель этапа: отсеивать повторяющиеся записи на потоке в миллионы строк, не держа все ключи в оперативной памяти.
Хеш записи
Когда у записи нет идентификатора, ключом становится хеш её содержимого. Чтобы одинаковые записи давали одинаковый хеш, содержимое нужно канонизировать: отсортировать ключи словаря, убрать лишние пробелы, зафиксировать разделители. Иначе одна и та же запись, пришедшая с другим порядком полей, получит другой хеш.
import hashlib
import json


def record_key(rec, fields=None):
src = rec if fields is None else {k: rec.get(k) for k in fields}
canon = json.dumps(src, sort_keys=True, ensure_ascii=False, separators=(',', ':'))
return hashlib.blake2b(canon.encode('utf-8'), digest_size=16).digest()
Функция возвращает 16 байт. Этого достаточно: вероятность случайного совпадения для сотни миллионов записей пренебрежимо мала. Параметр fields позволяет считать хеш только по стабильным полям, исключая, например, время последнего обновления, которое меняется при каждом запросе.
Почему множество в памяти не работает на миллионах
Первое, что приходит в голову: завести seen = set() и складывать туда ключи. Посчитаем. Один объект bytes длиной 16 байт занимает в Python около 49 байт плюс сами данные, итого примерно 65 байт. Слот в множестве с учётом коэффициента заполнения добавляет ещё около 30 байт. Получаем порядка 95 байт на ключ. На 10 миллионах записей это около 950 МБ, на 50 миллионах почти 5 ГБ. И главное: после перезапуска процесса множество пусто, и вся дедупликация начинается с чистого листа.
Три способа не раздувать память
- Хранить ключи в самой базе. Самый простой и надёжный путь. Если ключ является первичным ключом таблицы records, дедупликация уже сделана конструкцией INSERT OR IGNORE из шага 3. Индекс живёт на диске, переживает перезапуски, а SQLite сам кеширует горячие страницы индекса. Для 10 миллионов 16-байтовых ключей индекс займёт примерно 400-500 МБ на диске, но не в памяти.
- Отдельная таблица виденных ключей без rowid. Нужна, если сами данные вы пишете не в SQLite, а, например, в файлы. Тогда SQLite используется только как компактное множество на диске.
- Сжатое множество в памяти как предфильтр. Продвинутый вариант: усечь хеш до 8 байт и хранить как целое число в отсортированном массиве или использовать фильтр Блума. Память сокращается в несколько раз, но появляется вероятность ложного срабатывания. Поэтому такой предфильтр применяют только чтобы быстро отсечь заведомо новые записи, а окончательную проверку всё равно делают по базе.
Реализация множества на диске
class DiskSeen:
def __init__(self, con):
self.con = con
con.execute('CREATE TABLE IF NOT EXISTS seen(key BLOB PRIMARY KEY) WITHOUT ROWID')

def filter_new(self, rows):
keyed = [(record_key(r), r) for r in rows]
keys = [k for k, _ in keyed]
placeholders = ','.join('?' * len(keys))
known = {row[0] for row in self.con.execute(
'SELECT key FROM seen WHERE key IN (%s)' % placeholders, keys)}
fresh = [(k, r) for k, r in keyed if k not in known]
# дедупликация внутри самой страницы
unique = {}
for k, r in fresh:
unique.setdefault(k, r)
return unique

def remember(self, keys):
self.con.executemany('INSERT OR IGNORE INTO seen(key) VALUES (?)', [(k,) for k in keys])
Вызывайте filter_new перед записью страницы, а remember внутри той же транзакции, что и запись данных и чекпоинта. Тогда после падения множество виденных, данные и отметка прогресса всегда согласованы между собой.
Совет: запрос с IN на 500 значений выполняется по индексу за миллисекунды. Не проверяйте ключи по одному в цикле: это в десятки раз медленнее из-за накладных расходов на каждый запрос.
Ожидаемый результат
Проверка: сформируйте тестовую страницу из 500 записей, где 100 повторяются дважды внутри страницы и ещё 100 уже лежат в таблице seen. Функция filter_new должна вернуть ровно 300 записей. После перезапуска процесса те же 500 записей должны дать ноль новых.
Возможные проблемы
- Дубли всё равно проходят. Проверьте канонизацию: скорее всего, в записях есть поле с временем запроса или случайным порядком элементов в списке. Исключите его через параметр fields или отсортируйте вложенные списки перед хешированием.
- Медленная вставка после нескольких миллионов строк. Индекс перестал помещаться в кеш. Увеличьте кеш SQLite командой
PRAGMA cache_size=-200000(это 200 МБ) и убедитесь, что вставки идут пачками в одной транзакции на страницу, а не по одной строке.
Шаг 5: Параллелизм без потерь
Цель этапа: ускорить выгрузку несколькими одновременными воркерами через прокси так, чтобы падение любого из них не теряло задания и не ломало базу.
Когда параллелить можно, а когда нельзя
Курсорная пагинация по своей природе последовательна: следующий курсор известен только после получения предыдущей страницы. Параллелить её напрямую невозможно. Но почти всегда можно разбить выгрузку на независимые шарды: по дням, по категориям, по регионам, по первым символам идентификатора. Каждый шард выгружается последовательно со своим чекпоинтом, а шарды идут параллельно. Пагинация по смещению и по ключу с известными границами параллелится напрямую: задания вида «страницы с 1 по 100» или «идентификаторы от 0 до 100000».
Очередь заданий на диске
Очередь в памяти умирает вместе с процессом. Поэтому задания живут в таблице со статусами:
pending— ждёт выполнения;running— взято воркером;done— выполнено и записано;failed— исчерпаны попытки, требует внимания человека.
При старте загрузчик первым делом переводит все задания из running обратно в pending: если они висят в этом статусе, значит прошлый процесс умер посреди работы. Затем воркеры разбирают pending.
Одна точка записи
SQLite допускает много одновременных читателей, но только одного писателя. Самый простой и безопасный паттерн: воркеры только скачивают и возвращают данные, а всю запись в базу делает главный поток. Никаких блокировок в коде, никаких «database is locked». Дополнительно включите режим WAL, чтобы чтение состояния из другого процесса не мешало записи.
Ограничение одновременности
Число воркеров ограничивайте двумя вещами. Первое — возможности прокси: если в личном кабинете Proxeon у вас несколько каналов, разумно держать по одному-два воркера на канал, чтобы ротация IP на одном канале не рвала соединения всех потоков разом. Второе — вежливость к источнику: даже без формальных лимитов десять параллельных потоков на небольшой API создадут нагрузку, из-за которой вы получите отказы. Начинайте с трёх-четырёх воркеров и поднимайте, наблюдая за долей ошибок.
Код параллельного загрузчика
import json
import sqlite3
from concurrent.futures import ThreadPoolExecutor, as_completed


def init_tasks(con):
con.execute('PRAGMA journal_mode=WAL')
con.executescript('''
CREATE TABLE IF NOT EXISTS tasks(
task_id TEXT PRIMARY KEY,
params TEXT NOT NULL,
status TEXT NOT NULL DEFAULT 'pending',
attempts INTEGER NOT NULL DEFAULT 0,
last_error TEXT
);
''')
with con:
con.execute('UPDATE tasks SET status=? WHERE status=?', ('pending', 'running'))


def enqueue(con, tasks):
with con:
con.executemany('INSERT OR IGNORE INTO tasks(task_id, params) VALUES (?, ?)',
[(t['task_id'], json.dumps(t['params'])) for t in tasks])


def claim(con, limit):
rows = con.execute('SELECT task_id, params FROM tasks WHERE status=? LIMIT ?',
 ('pending', limit)).fetchall()
with con:
con.executemany('UPDATE tasks SET status=? WHERE task_id=?',
[('running', r[0]) for r in rows])
return [(r[0], json.loads(r[1])) for r in rows]


def run_parallel(con, fetch_fn, write_fn, workers=4, max_attempts=5):
init_tasks(con)
with ThreadPoolExecutor(max_workers=workers) as pool:
while True:
batch = claim(con, workers * 2)
if not batch:
break
futures = {pool.submit(fetch_fn, params): task_id for task_id, params in batch}
for fut in as_completed(futures):
task_id = futures[fut]
try:
rows = fut.result()
except Exception as e:
with con:
con.execute(
'UPDATE tasks SET attempts=attempts+1, last_error=?, '
'status=CASE WHEN attempts+1 >= ? THEN ? ELSE ? END WHERE task_id=?',
(str(e)[:500], max_attempts, 'failed', 'pending', task_id))
continue
with con: # данные и статус задания в одной транзакции
write_fn(con, rows)
con.execute('UPDATE tasks SET status=? WHERE task_id=?', ('done', task_id))
failed = con.execute('SELECT count(*) FROM tasks WHERE status=?', ('failed',)).fetchone()[0]
print('очередь пуста, заданий с ошибкой:', failed)
Функция fetch_fn выполняет запрос через прокси и возвращает список записей. Она работает в потоке и не трогает базу. Функция write_fn вызывается в главном потоке внутри транзакции и делает идемпотентную вставку из шага 3. Упавшее задание автоматически возвращается в pending и будет взято снова в следующем цикле claim; после исчерпания попыток оно получает статус failed, и вы разберётесь с ним вручную.
Внимание: не передавайте объект соединения sqlite3 в воркеры. Соединение привязано к потоку, в котором создано, и попытка использовать его из другого потока приведёт к ошибке или, что хуже, к тихому повреждению данных. Каждому потоку либо своё соединение, либо, как в примере выше, никакого.
Совет: используйте на каждый воркер отдельный объект requests.Session с собственным прокси-адресом. Если у вас в Proxeon несколько каналов, распределите их по воркерам по кругу: воркер 0 берёт канал 0, воркер 1 канал 1 и так далее. Так падение соединения на одном канале затронет только один поток.
Ожидаемый результат
Проверка: поставьте в очередь 100 заданий, запустите четыре воркера и убейте процесс через полминуты. Выполните SELECT status, count(*) FROM tasks GROUP BY status;. Вы увидите несколько done, несколько running и остальные pending. Запустите снова: running должны исчезнуть при старте, а по завершении все задания оказаться в done, кроме тех, что честно упали и лежат в failed с текстом ошибки в last_error.
Шаг 6: Возобновление после долгого перерыва
Цель этапа: корректно продолжить выгрузку, которую остановили на несколько часов или дней, и не наткнуться на протухшее состояние.
Что протухает
Возобновление через десять секунд и через неделю это разные задачи. За долгий перерыв часть сохранённого состояния перестаёт быть действительной.
- Сессии и cookies. Серверные сессии обычно живут от нескольких часов до суток. Сохранённые cookies после этого приведут к ответам 401 или редиректу на форму входа. Решение: при старте выполнять полноценную повторную авторизацию, а не восстанавливать cookies из файла.
- Токены доступа. Токены OAuth живут по часу, иногда меньше. Если у вас есть refresh-токен, обновляйте access-токен перед стартом и по расписанию во время работы, не дожидаясь отказа.
- Курсоры пагинации. Многие API ограничивают срок жизни курсора минутами или часами. Протухший курсор вернёт ошибку 400 с сообщением о недействительном курсоре. Именно поэтому в шаге 2 мы сохраняли запасной якорь: идентификатор последней записи. Если источник поддерживает фильтр по идентификатору или по дате изменения, стройте новый запрос от этого якоря. Если не поддерживает, придётся начать шард с начала, а дедупликация из шага 4 отсеет уже полученное.
- Содержимое файла на сервере. Для докачки из шага 1 критично, что файл не изменился. Сравните текущий ETag с сохранённым перед каждым заходом; при несовпадении начинайте файл заново.
- Настройки прокси. За неделю в личном кабинете Proxeon могли поменяться порт, пароль или закончиться срок канала. Проверяйте прокси тестовым запросом до того, как начать разбирать очередь.
- Сам набор данных. Если выгрузка идёт неделю, а источник за это время добавил и удалил записи, ваш результат будет смесью состояний на разные моменты времени. Для многих задач это приемлемо. Если нет, храните время старта в чекпоинте и после завершения делайте отдельный инкрементальный проход по записям, изменённым после этого времени.
Предполётная проверка
Соберите все проверки в одну функцию, которая выполняется при старте до любой реальной работы. Она либо приводит состояние в порядок, либо останавливает загрузчик с понятным сообщением.
def preflight(session, state, probe_url):
# 1. прокси жив и авторизован
r = session.head(probe_url, timeout=20)
if r.status_code == 407:
raise SystemExit('прокси отверг логин или пароль, проверьте данные в кабинете Proxeon')
# 2. токен доступа свежий
refresh_access_token(session)
# 3. курсор ещё действителен
if state['cursor']:
test = session.get(API_BASE + '/orders', params={'cursor': state['cursor'], 'limit': 1}, timeout=30)
if test.status_code == 400 and 'cursor' in test.text.lower():
print('курсор протух, переключаемся на якорь по last_id =', state['last_id'])
state['cursor'] = None
state['resume_after_id'] = state['last_id']
# 4. напоминание о возрасте выгрузки
print('выгрузка стартовала', state['started_at'], 'страниц записано', state['pages'])
return state
Функция refresh_access_token зависит от вашего источника: обычно это POST-запрос с refresh-токеном, после которого вы обновляете заголовок Authorization в сессии. Поле resume_after_id затем используется в функции получения страницы как фильтр «идентификатор больше указанного».
Совет: храните refresh-токен и пароль прокси не в чекпоинте, а в переменных окружения или в отдельном файле секретов с ограниченными правами доступа. Чекпоинт вы будете копировать, пересылать коллегам и прикладывать к отчётам об ошибках; секреты там лишние.
Ожидаемый результат
Проверка: вручную испортите курсор в таблице checkpoint командой UPDATE checkpoint SET cursor='broken'; и запустите загрузчик. В консоли должна появиться строка о переключении на якорь по last_id, а выгрузка продолжиться без падения. Количество записей после завершения должно совпасть с контрольным запуском без порчи курсора.
Шаг 7: Готовый скелет устойчивого загрузчика на Python
Цель этапа: собрать всё из предыдущих шагов в один файл, который можно запустить, прервать, запустить снова и получить полный результат без дублей.
Структура скелета
- Конфигурация из переменных окружения: адрес прокси Proxeon, адрес API, токен, имя задания.
- Класс Store: SQLite с таблицами записей и чекпоинта, одна транзакция на страницу.
- Функция ключа записи для идемпотентности.
- Функция получения страницы через прокси.
- Основной цикл с возобновлением по чекпоинту и пересозданием сессии после обрыва.
Полный код
# resumable_loader.py
import hashlib
import json
import os
import sqlite3
import time
from datetime import datetime, timezone

import requests

PROXY_URL = os.environ['PROXY_URL']# http://USER:PASS@HOST:PORT из кабинета Proxeon
API_BASE = os.environ.get('API_BASE', 'https://api.example.com')
API_TOKEN = os.environ.get('API_TOKEN', '')
DB_PATH = os.environ.get('DB_PATH', 'export.sqlite')
JOB = os.environ.get('JOB', 'orders-2026')
PAGE_SIZE = 500
MAX_ATTEMPTS = 8
FIELDS = ('cursor', 'last_id', 'pages', 'rows', 'started_at')


def now():
return datetime.now(timezone.utc).isoformat()


def record_key(rec):
canon = json.dumps({'id': rec['id']}, sort_keys=True, separators=(',', ':'))
return hashlib.blake2b(canon.encode('utf-8'), digest_size=16).digest()


class Store:
def __init__(self, path):
self.con = sqlite3.connect(path)
self.con.execute('PRAGMA journal_mode=WAL')
self.con.executescript('''
CREATE TABLE IF NOT EXISTS records(
key BLOB PRIMARY KEY,
payload TEXT NOT NULL,
fetched_at TEXT NOT NULL
) WITHOUT ROWID;
CREATE TABLE IF NOT EXISTS checkpoint(
job TEXT PRIMARY KEY,
cursor TEXT,
last_id TEXT,
pages INTEGER NOT NULL,
rows INTEGER NOT NULL,
started_at TEXT,
updated_at TEXT
);
''')

def load(self, job):
row = self.con.execute(
'SELECT cursor, last_id, pages, rows, started_at FROM checkpoint WHERE job=?',
(job,)).fetchone()
if row is None:
return {'cursor': None, 'last_id': None, 'pages': 0, 'rows': 0, 'started_at': now()}
return dict(zip(FIELDS, row))

def commit_page(self, job, rows, state):
ts = now()
with self.con:
self.con.executemany(
'INSERT OR IGNORE INTO records(key, payload, fetched_at) VALUES (?, ?, ?)',
[(record_key(r), json.dumps(r, ensure_ascii=False), ts) for r in rows])
self.con.execute(
'INSERT INTO checkpoint(job, cursor, last_id, pages, rows, started_at, updated_at) '
'VALUES (?, ?, ?, ?, ?, ?, ?) '
'ON CONFLICT(job) DO UPDATE SET cursor=excluded.cursor, last_id=excluded.last_id, '
'pages=excluded.pages, rows=excluded.rows, updated_at=excluded.updated_at',
(job, state['cursor'], state['last_id'], state['pages'], state['rows'],
 state['started_at'], ts))

def unique_count(self):
return self.con.execute('SELECT count(*) FROM records').fetchone()[0]


def make_session():
s = requests.Session()
s.proxies = {'http': PROXY_URL, 'https': PROXY_URL}
s.headers['User-Agent'] = 'resumable-loader/1.0'
if API_TOKEN:
s.headers['Authorization'] = 'Bearer ' + API_TOKEN
return s


def fetch_page(session, cursor):
params = {'limit': PAGE_SIZE}
if cursor:
params['cursor'] = cursor
r = session.get(API_BASE + '/orders', params=params, timeout=(15, 90))
r.raise_for_status()
body = r.json()
return body['items'], body.get('next_cursor')


def run():
store = Store(DB_PATH)
state = store.load(JOB)
print('старт: страниц %d, строк %d, уникальных в базе %d'
 % (state['pages'], state['rows'], store.unique_count()))
session = make_session()
attempts = 0
while True:
try:
items, next_cursor = fetch_page(session, state['cursor'])
attempts = 0
except (requests.ConnectionError, requests.Timeout, requests.HTTPError) as e:
attempts += 1
if attempts > MAX_ATTEMPTS:
print('попытки исчерпаны, состояние сохранено, запустите снова позже')
raise
print('обрыв (%s), попытка %d из %d' % (type(e).__name__, attempts, MAX_ATTEMPTS))
time.sleep(min(60, 2 ** attempts)) # выбор пауз описан в статье про 429 и ретраи
session = make_session() # новая сессия: соединение через прокси пересоздаётся
continue
if not items:
break
state['pages'] += 1
state['rows'] += len(items)
state['last_id'] = str(items[-1]['id'])
state['cursor'] = next_cursor
store.commit_page(JOB, items, state)
if state['pages'] % 20 == 0:
print('страниц %d, строк %d' % (state['pages'], state['rows']))
if next_cursor is None:
break
print('готово: страниц %d, строк получено %d, уникальных в базе %d'
 % (state['pages'], state['rows'], store.unique_count()))


if __name__ == '__main__':
run()
Как адаптировать под свой источник
- Замените путь
/ordersи имена полейitems,next_cursor,idна те, что отдаёт ваш API. Это три места в функциях fetch_page и record_key. - Если у источника пагинация по смещению, замените параметр cursor на page и вычисляйте следующее значение как state['pages'] + 1. В чекпоинт вместо курсора сохраняйте номер страницы.
- Если пагинация по ключу, передавайте параметр вроде
after_idиз state['last_id'] и уберите работу с курсором. - Если нужен параллелизм, вынесите fetch_page в fetch_fn из шага 5, а commit_page используйте как write_fn. Разбейте выгрузку на шарды и заполните очередь заданий.
- Добавьте функцию preflight из шага 6 перед основным циклом.
Проверка результата: чек-лист
Прежде чем запускать загрузчик на реальный многочасовой объём, прогоните его через этот список. Каждый пункт занимает пару минут, а вместе они гарантируют, что ночная выгрузка не потеряет данные.
- Тест на прерывание. Запустите загрузчик, через 30 секунд нажмите Ctrl+C. Запустите снова. Первая строка вывода должна показывать ненулевое число страниц, а не «страниц 0».
- Тест на дубли. Уменьшите PAGE_SIZE до 10, прервите загрузчик пять раз подряд в случайные моменты. По завершении сравните число уникальных записей с числом полученных строк: уникальных должно быть меньше или равно, а при чистой курсорной пагинации без вставок в источник почти равно.
- Тест на согласованность. После любого прерывания выполните два запроса:
SELECT rows FROM checkpoint;иSELECT count(*) FROM records;. Разница между ними не должна превышать одного размера страницы. Если превышает, чекпоинт и данные пишутся не в одной транзакции. - Тест на прокси. На время отключите переменную PROXY_URL или укажите неверный пароль. Загрузчик должен упасть на первом запросе с понятной ошибкой, а не зависнуть и не начать ходить в источник напрямую.
- Тест на протухший курсор. Испортите курсор в базе, как описано в шаге 6, и убедитесь, что срабатывает переключение на якорь.
- Тест на диск. Проверьте размер файла export.sqlite после тысячи страниц и умножьте на ожидаемое число страниц. Убедитесь, что на диске хватит места с запасом 20 процентов.
Проверка: показателем успешного выполнения считается ситуация, когда после трёх намеренных прерываний и трёх перезапусков итоговое количество уникальных записей совпадает с количеством, полученным за один непрерывный прогон на том же источнике, а в консоли ни разу не появилась строка про старт с нуля.
Дополнительные возможности и оптимизация
- Прогресс и оценка времени. Если известно общее число записей, выводите процент и оценку оставшегося времени раз в двадцать страниц. Это полезно и для вас, и для того, чтобы отличать зависание от медленной работы.
- Сжатие payload. Для десятков миллионов записей JSON в текстовом виде занимает много места. Сжимайте поле payload функцией zlib.compress перед записью и храните как BLOB. Экономия обычно от трёх до восьми раз.
- Переезд на серверную базу. Схема с чекпоинтом в одной транзакции с данными переносится на PostgreSQL почти без изменений. Конструкция ON CONFLICT там поддерживается, а ограничение «один писатель» исчезает.
- Инкрементальные выгрузки. Сохраняйте время старта каждого задания и после полной выгрузки запускайте отдельное задание с фильтром «изменено после». Так вы поддерживаете актуальную копию без полной перезакачки.
- Отдельный процесс на шард. Вместо потоков можно запускать несколько экземпляров скрипта с разными значениями JOB и разными файлами DB_PATH, а объединять результаты в конце. Это проще в отладке и полностью снимает вопрос конкурентной записи.
- Метрики обрывов. Логируйте каждый обрыв с типом исключения и временем. Через сутки вы увидите, что обрывы группируются вокруг интервалов ротации IP на канале Proxeon, и сможете подобрать интервал ротации под длительность ваших запросов.
Типичные ошибки и решения
Ниже собраны ситуации, с которыми сталкивается почти каждый на первых запусках. Формат: проблема, причина, решение.
- Проблема: после перезапуска выгрузка каждый раз начинается с нуля. Причина: чекпоинт пишется в память или в файл, который не переживает падение, либо загрузчик не читает его при старте. Решение: убедитесь, что первое действие в функции run это store.load, а состояние обновляется после каждой страницы внутри транзакции.
- Проблема: в базе в полтора раза больше записей, чем в источнике. Причина: ключ дедупликации нестабилен: в него попало время запроса, номер страницы или поле со случайным порядком. Решение: считайте ключ только по идентификатору источника или по явному списку стабильных полей через параметр fields.
- Проблема: в базе меньше записей, чем в источнике, хотя выгрузка завершилась без ошибок. Причина: чекпоинт обновлялся до записи данных, и после падения страница была пропущена. Либо пагинация по смещению при удалении записей в источнике сдвинула страницы назад. Решение: поменяйте порядок на «данные, потом чекпоинт» в одной транзакции; для источников с удалениями переходите на пагинацию по ключу.
- Проблема: докачка файла даёт битый архив при совпадающем размере. Причина: сервер один раз ответил 200 вместо 206, файл был перезаписан частично, а затем дописан. Решение: храните ETag рядом с файлом, при изменении удаляйте файл; проверяйте заголовок Content-Range на соответствие запрошенному смещению.
- Проблема: ошибка «database is locked» при параллельной работе. Причина: несколько потоков пишут в SQLite одновременно или соединение передано между потоками. Решение: одна точка записи в главном потоке, воркеры только скачивают; режим WAL; соединение создаётся в том потоке, где используется.
- Проблема: через час работы все запросы начали возвращать 401. Причина: истёк токен доступа. Решение: обновляйте токен по расписанию до истечения, а при получении 401 вызывайте обновление и повторяйте запрос один раз, не считая это обрывом.
- Проблема: оперативная память растёт до нескольких гигабайт. Причина: множество виденных ключей или список всех записей держится в памяти процесса. Решение: дедупликация через первичный ключ в базе или таблицу seen; запись данных постранично, без накопления.
- Проблема: обрывы происходят строго каждые несколько минут. Причина: совпадают с интервалом ротации IP на канале прокси. Решение: это штатная ситуация, загрузчик должен её переживать. Если запросы длинные, подберите интервал ротации в личном кабинете Proxeon так, чтобы он был заметно больше типичного времени одного запроса, либо используйте ротацию по запросу между страницами.
FAQ: частые вопросы по устойчивой выгрузке
Обязательно ли использовать SQLite, если результат нужен в CSV?
Нет, но удобно. SQLite здесь выполняет роль надёжного хранилища состояния и множества виденных ключей. Итоговый CSV вы выгружаете одной командой из таблицы records после завершения. Если хочется совсем без базы, используйте файловый вариант из шага 3 с одним файлом на страницу и JSON-чекпоинтом с атомарной заменой.
Как часто сохранять чекпоинт: после каждой страницы или реже?
После каждой страницы. Одна транзакция SQLite с несколькими сотнями строк выполняется за единицы миллисекунд, это ничтожно по сравнению с сетевым запросом через прокси. Экономия на редких чекпоинтах не стоит риска потерять десятки страниц.
Что делать, если API не отдаёт ни курсор, ни идентификаторы, только номера страниц?
Работайте по номеру страницы, храните его в чекпоинте и обязательно включайте дедупликацию по хешу содержимого записи. Примите, что при активных изменениях в источнике часть записей может быть пропущена из-за сдвига страниц. Для критичных данных сделайте второй проход в обратном порядке страниц: пропущенное при первом проходе с высокой вероятностью попадёт во второй.
Можно ли докачивать файл несколькими потоками разными диапазонами?
Можно, если сервер поддерживает Range. Разбейте файл на куски по 50-100 МБ, каждый кусок это задание из очереди шага 5 со своим временным файлом, а по завершении всех кусков склейте их в правильном порядке. Проверяйте каждый кусок по размеру, а весь файл по контрольной сумме, если она есть.
Сколько воркеров ставить при работе через прокси?
Начните с трёх-четырёх на один канал Proxeon и наблюдайте за долей ошибок в таблице tasks. Если ошибок меньше одного процента, добавьте ещё два. Если ошибки растут, уменьшайте. Больше десяти потоков на один канал редко дают выигрыш: упираетесь либо в пропускную способность канала, либо в терпение источника.
Нужно ли сохранять сами cookies сессии между запусками?
Обычно нет. Повторная авторизация при старте занимает секунды и надёжнее, чем восстановление cookies с неизвестным сроком жизни. Исключение: источник ограничивает число входов в сутки. Тогда сохраняйте cookies, но при первом же 401 или редиректе на вход выбрасывайте их и авторизуйтесь заново.
Как понять, что выгрузка завершилась полностью, а не оборвалась тихо?
Для файлов: размер равен Content-Length и контрольная сумма совпадает. Для API: получена страница без next_cursor или пустая страница, и при этом число строк соответствует общему количеству, если источник его сообщает. Записывайте в чекпоинт явный флаг завершения, чтобы повторный запуск не начинал новый обход.
Что делать с заданиями в статусе failed?
Посмотрите поле last_error. Если это сетевые ошибки, просто верните задания в pending командой UPDATE и запустите загрузчик снова. Если это ошибки разбора данных, значит в источнике есть записи нестандартной формы: исправьте код и перезапустите. Никогда не удаляйте failed молча, это единственное свидетельство того, чего не хватает в выгрузке.
Можно ли использовать этот подход не с requests, а с асинхронной библиотекой?
Да, принципы те же: атомарная единица работы, чекпоинт вместе с данными, идемпотентная запись, очередь на диске. Меняется только транспорт. Единственный нюанс: запись в SQLite оставьте синхронной и последовательной, а параллелизм держите на уровне сетевых запросов.
Заключение
Вы прошли путь от неполного файла и нервного перезапуска до загрузчика, которому обрыв безразличен. Давайте зафиксируем, что именно сделано.
- Разобрались с докачкой по HTTP: проверка Accept-Ranges через HEAD, заголовок Range с текущим размером файла, различение кодов 206 и 200, защита от подмены файла через ETag и If-Range.
- Построили чекпоинты для постраничных выгрузок: курсор, номер страницы или идентификатор последней записи плюс служебные счётчики, всё в одной транзакции с данными.
- Сделали запись идемпотентной через первичный ключ и конструкцию INSERT OR IGNORE или ON CONFLICT DO UPDATE, а для файлов через детерминированные имена и атомарную замену.
- Организовали дедупликацию на диске, чтобы миллионы ключей не жили в оперативной памяти и переживали перезапуски.
- Добавили параллелизм с очередью заданий в SQLite, автоматическим возвратом упавших задач и единственной точкой записи.
- Предусмотрели возобновление после долгого перерыва: обновление токенов, повторная авторизация, переключение с протухшего курсора на якорь по идентификатору, проверка прокси Proxeon до старта.
- Собрали всё в один рабочий скелет, который адаптируется под конкретный источник заменой трёх-четырёх строк.
Что делать дальше
Возьмите скелет из шага 7 и запустите его на небольшом реальном объёме, скажем, на десяти тысячах записей. Прогоните чек-лист из раздела проверки. Только после этого запускайте полную выгрузку на ночь. Утром вы либо увидите строку «готово» с совпадающими счётчиками, либо строку про исчерпанные попытки с сохранённым состоянием, и тогда просто запустите скрипт ещё раз.
Куда развиваться
Следующий уровень это инкрементальные выгрузки по времени изменения вместо полных обходов, перенос состояния в серверную базу для нескольких машин, а также осмысленная стратегия повторов с учётом кодов ответа, которой посвящена отдельная статья про 429 и ретраи. Сочетание грамотных ретраев из той статьи и устойчивого состояния из этой даёт загрузчик, который можно оставить работать на неделю и не открывать терминал.
И последнее. Обрыв длинной выгрузки это не авария, а рабочая ситуация, которую вы теперь умеете обрабатывать. Удачных выгрузок.