Исходящий трафик в Kubernetes и прокси: env пода, sidecar, egress-шлюз и роль NO_PROXY
Содержание статьи
- Введение: почему настройка «как на обычном сервере» в кластере не работает
- Основы: как физически устроен исходящий трафик пода
- Три уровня, где можно поставить прокси: контейнер, sidecar, egress-шлюз
- Переменные окружения в манифесте: http_proxy, https_proxy, no_proxy и почему без правильного no_proxy ломается кластер
- Что не подхватывает эти переменные: kubelet, образы с собственной конфигурацией, sdk
- Секреты: креды прокси через secret, а не в манифест
- Sidecar-подход: когда оправдан и что даёт помимо прокси
- Egress-шлюз кластера: единая точка выхода
- Диагностика в кластере: как проверить исходящий ip из пода и где смотреть отказы
- Типичные ошибки
- Инструменты и ресурсы
- Кейсы и результаты
- Чеклист выката
- Faq
- Заключение
Введение: почему настройка «как на обычном сервере» в кластере не работает
На обычной виртуальной машине настройка прокси занимает пять минут. Вы прописываете HTTP_PROXY в профиле, добавляете пару адресов в исключения, перезапускаете сервис и идёте пить кофе. В Kubernetes такой сценарий заканчивается по-другому: половина сервисов внезапно отвечает 502, health-check начинает валить поды, а платёжный сервис жалуется, что не может достучаться до соседнего пода. И при этом внешние запросы, ради которых всё затевалось, вообще-то работают.
Почему так? Потому что в кластере у одного процесса одновременно живут два мира сетевого общения. Первый — внешний интернет: API партнёров, маркетплейсы, источники данных для парсинга, публичные сервисы. Второй — внутренняя сеть кластера: другие сервисы через ClusterIP, API-сервер Kubernetes, DNS, базы данных, очереди, метрики. На обычном сервере второй мир почти пуст, поэтому глобальная переменная прокси ничего не ломает. В кластере второй мир огромен, и любой прокси, который получит запрос к адресу вида payments.default.svc.cluster.local, просто не сможет его разрешить. Прокси стоит снаружи и о вашем внутреннем DNS ничего не знает.
Добавим сюда особенности самого Kubernetes. Переменные окружения пода не влияют на kubelet и container runtime. Образы часто приносят собственную конфигурацию, которая игнорирует окружение. У SDK разных языков разное понимание того, что такое исключение из проксирования. И всё это — на фоне того, что исходящий IP пода внешнему миру вообще не виден: наружу уходит адрес ноды или NAT-шлюза облака.
В этом руководстве мы разберём исходящий трафик Kubernetes «по слоям»: как пакет физически покидает под, где именно можно вклинить прокси, почему NO_PROXY в кластере превращается из формальности в критичный элемент архитектуры, как безопасно передать креды, когда sidecar оправдан, а когда избыточен, и как отлаживать отказы, не гадая. Базовый синтаксис переменных окружения мы пересказывать не будем — здесь только специфика кластера. Все фрагменты манифестов рабочие, их можно брать за основу.
Основы: как физически устроен исходящий трафик пода
Прежде чем ставить прокси, полезно понимать, по какому пути идёт пакет без него. Иначе диагностика превращается в угадывание.
От контейнера до ноды
Каждый под получает собственный IP из pod CIDR, например 10.244.3.17. Внутри пода все контейнеры делят одно сетевое пространство имён: один IP, один набор интерфейсов, общий localhost. Это ключевой факт для sidecar-подхода, к которому мы вернёмся. Пакет из контейнера выходит через виртуальный интерфейс пода на ноду, где им занимается CNI-плагин. Дальше два сценария.
- Адресат внутри кластера. Если приложение обращается к ClusterIP сервиса (например 10.96.14.2), kube-proxy или eBPF-датаплейн CNI подменяет адрес назначения на IP конкретного пода-бэкенда. Трафик уходит на нужную ноду по оверлею или напрямую по L3 и никогда не покидает кластер.
- Адресат снаружи. Если адрес не принадлежит ни pod CIDR, ни service CIDR, пакет уходит через маршрут по умолчанию ноды. На выходе с ноды почти всегда срабатывает SNAT: адрес источника 10.244.3.17 заменяется на IP ноды. В облаках поверх этого может работать NAT-шлюз, и тогда внешний мир видит уже его адрес.
Отсюда первый практический вывод: внешний сервис никогда не видит IP пода. Он видит IP ноды или облачного NAT. Если у вас автоскейлинг нод, исходящие IP меняются вместе с ними. Именно поэтому авторизация на прокси по IP-адресу без выделенного egress-узла в кластере работает плохо — об этом ниже.
DNS внутри кластера
Поды используют кластерный DNS (обычно CoreDNS). В файле resolv.conf пода прописаны домены поиска: namespace.svc.cluster.local, svc.cluster.local, cluster.local. Благодаря этому имя payments раскрывается в payments.default.svc.cluster.local. Внешний прокси о такой схеме понятия не имеет. Он получит запрос к хосту payments, попробует разрешить его через публичный DNS и вернёт ошибку. Это фундаментальная причина, по которой NO_PROXY в кластере важнее, чем на любом отдельно стоящем сервере.
Что вообще значит «поставить прокси» в кластере
Под этой фразой инженеры понимают три разных вещи, и путать их опасно:
- Заставить конкретное приложение ходить наружу через прокси-сервер (например, через выделенные адреса Proxeon), не трогая остальные сервисы.
- Обеспечить стабильный и предсказуемый исходящий IP для целого кластера или его части — задача корпоративной сети, комплаенса, аудита.
- Централизовать управление внешним трафиком: логирование, лимиты, единая точка выхода.
Первая задача решается на уровне пода. Вторая и третья — на уровне кластера. Смешивание уровней порождает большую часть проблем, о которых мы будем говорить.
Три уровня, где можно поставить прокси: контейнер, sidecar, egress-шлюз
Представьте кластер как офисное здание. Прокси можно выдать каждому сотруднику лично (контейнер), посадить помощника рядом с каждым рабочим местом (sidecar) или поставить одну проходную на выходе из здания (egress-шлюз). У каждой схемы своя цена.
Уровень 1: сам контейнер
Приложение получает адрес прокси через переменные окружения, конфигурационный файл или флаги запуска и само направляет трафик через него. Это самый простой и самый распространённый способ.
Плюсы:
- Ноль дополнительной инфраструктуры: изменения только в манифесте Deployment.
- Гранулярность: одному сервису прокси нужен, соседнему — нет.
- Прокси «понимает» протокол: HTTP-прокси видит хост назначения, может логировать, применять правила.
Минусы:
- Работает только если код или библиотека уважают настройки. Java, часть Node.js-клиентов, некоторые gRPC-реализации требуют отдельной конфигурации.
- Полная зависимость от корректного NO_PROXY: одна ошибка — и внутрикластерное общение сломано.
- Креды прокси оказываются в окружении процесса и доступны любому, кто может выполнить exec в контейнер.
- Ротация прокси или смена адреса требует пересоздания подов.
Уровень 2: sidecar-контейнер
Рядом с приложением в том же поде запускается второй контейнер — локальный форвард-прокси. Приложение отправляет трафик на localhost:3128 (или его перехватывают правилами iptables), а sidecar уже решает, куда и как отправить дальше: через какой из upstream-прокси, с какой авторизацией, с каким таймаутом.
Плюсы:
- Приложение не знает про внешние креды: они живут только в sidecar.
- Единая точка логики: ротация, повторы, выбор пула адресов, метрики — без правки кода приложения.
- Транспарентный режим через iptables работает даже с библиотеками, игнорирующими HTTP_PROXY.
- Обновление логики проксирования — это обновление одного образа sidecar.
Минусы:
- Дополнительный контейнер в каждом поде: память, CPU, ещё один объект для мониторинга.
- Транспарентный перехват требует NET_ADMIN в init-контейнере, что не везде допустимо политиками безопасности.
- Сложнее отлаживать: два места, где может сломаться.
Уровень 3: egress-шлюз кластера
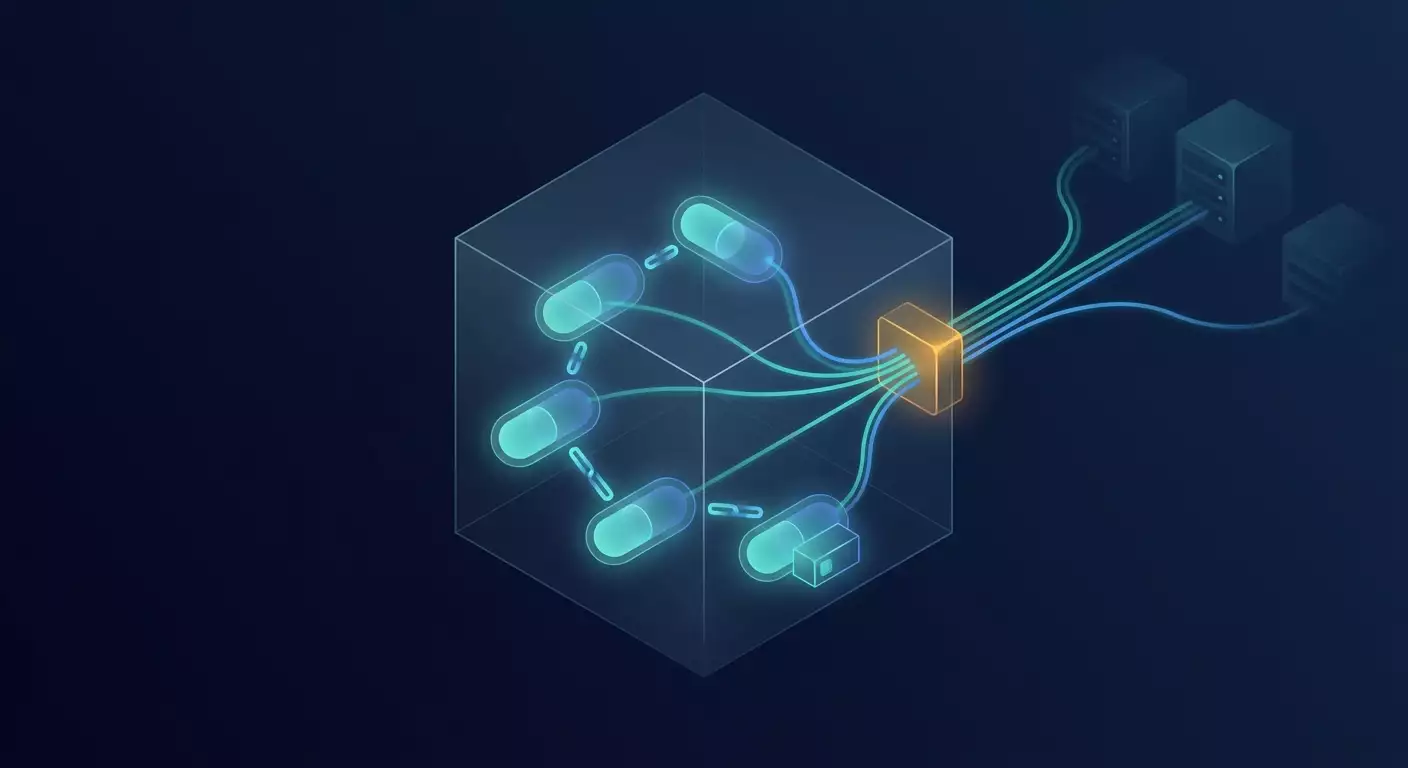
Выделенный набор подов (или нод) становится единственной точкой выхода. Остальные поды либо явно ходят через внутренний Service шлюза, либо принуждаются к этому сетевыми политиками и маршрутизацией. Шлюз уже наружу ходит напрямую или через внешний прокси.
Плюсы:
- Один стабильный исходящий IP (или их небольшой набор) для всего кластера. Идеально для авторизации по IP на стороне провайдера прокси и для белых списков партнёров.
- Централизованные логи, лимиты, аудит.
- Приложения не хранят никаких кредов: они видят только внутренний адрес шлюза.
- Ротация внешних адресов происходит в одном месте.
Минусы:
- Единая точка отказа: шлюз нужно делать отказоустойчивым (несколько реплик, PodDisruptionBudget, anti-affinity).
- Дополнительный сетевой хоп и потенциальное узкое место по пропускной способности.
- Требует продуманных NetworkPolicy, иначе остаётся «дыра» с прямым выходом мимо шлюза.
- Сложнее гранулярность: если разным командам нужны разные внешние адреса, придётся поднимать несколько шлюзов.
Как выбрать
Практическое правило, которое мы используем при проектировании:
- Одно-два приложения, код под контролем, стандартные HTTP-клиенты — уровень контейнера.
- Много сервисов с разными стеками, требования к ротации и повторам, нежелание раздавать креды — sidecar.
- Требования комплаенса, авторизация по IP, аудит всего внешнего трафика, десятки команд — egress-шлюз, часто в сочетании с sidecar для тонкой логики.
Обратите внимание: уровни не исключают друг друга. Типичная зрелая схема — egress-шлюз как обязательная граница плюс переменные окружения или sidecar там, где нужна специфика.
Переменные окружения в манифесте: HTTP_PROXY, HTTPS_PROXY, NO_PROXY и почему без правильного NO_PROXY ломается кластер
Синтаксис самих переменных вы знаете. Нас интересует, что происходит с ними именно в поде и почему стандартного значения NO_PROXY «localhost,127.0.0.1» здесь катастрофически мало.
Анатомия отказа
Разберём цепочку. Сервис orders вызывает payments по адресу http://payments:8080/charge. В окружении задан HTTP_PROXY. HTTP-клиент смотрит на хост назначения, не находит его в NO_PROXY и вместо TCP-соединения с payments открывает соединение с прокси и отправляет ему запрос GET http://payments:8080/charge. Прокси пытается разрешить имя payments через свой резолвер. Имени нет. Прокси возвращает 502 или 503. Ваш сервис получает ошибку от прокси, но в логах она выглядит как ошибка от payments. Команда идёт чинить payments, который абсолютно здоров.
Есть и второй, более коварный вариант. Если сервис обращается к ClusterIP напрямую по адресу вида 10.96.14.2, прокси получит запрос к приватному адресу. Некоторые прокси такие запросы отбрасывают сразу, другие пытаются подключиться к 10.96.14.2 в своей собственной сети. В худшем случае там есть какой-то другой хост с таким адресом.
Третий вариант касается самого Kubernetes. Клиентские библиотеки, которые общаются с API-сервером (операторы, контроллеры, приложения с leader election), используют адрес kubernetes.default.svc или IP из переменной KUBERNETES_SERVICE_HOST. Без исключения они тоже пойдут через прокси и потеряют связь с control plane.
Что обязано быть в NO_PROXY для пода
Минимальный набор, который мы рекомендуем как отправную точку. Подставьте свои CIDR — их можно узнать из конфигурации кластера или из аннотаций сервисов:
- localhost, 127.0.0.1, ::1 — локальные адреса, включая связь с sidecar.
- .svc, .svc.cluster.local, .cluster.local — все сервисные имена. Ведущая точка означает «любой поддомен».
- kubernetes.default.svc, kubernetes.default.svc.cluster.local — явно, для клиентов API.
- Service CIDR, например 10.96.0.0/12 — прямые обращения к ClusterIP.
- Pod CIDR, например 10.244.0.0/16 — headless-сервисы и обращения pod-to-pod.
- Node CIDR — если приложение ходит на порты ноды (метрики, hostNetwork-сервисы).
- 169.254.169.254 — метаданные облака, если используются.
- Внутренние домены компании, например .corp.local, если к ним есть прямой маршрут из кластера.
- Адреса внутренних баз и очередей, если они вне кластера, но в приватной сети.
Ловушка, о которой знают не все: CIDR поддерживают не все клиенты
Вот здесь начинается настоящая специфика. Формат NO_PROXY не стандартизирован. Каждая библиотека парсит его по-своему:
- Go (net/http) понимает CIDR-нотацию, суффиксы с ведущей точкой и отдельные хосты. Это лучший случай, и большинство инструментов Kubernetes написаны на Go.
- curl поддерживает CIDR только начиная с версии 7.86. В старых образах на базе устаревших дистрибутивов запись 10.96.0.0/12 будет просто проигнорирована.
- Python (urllib, requests) CIDR не понимает вовсе. Сравнение идёт по суффиксу строки. Запись 10.96.0.0/12 не сработает никогда; при этом запись 10.96. сработает как префикс-подобное совпадение только для хостов, оканчивающихся на эту строку, то есть тоже не поможет.
- Node.js встроенный HTTP-клиент переменные окружения игнорирует полностью. Нужен ProxyAgent в undici или сторонний агент, и уже он решает, как трактовать NO_PROXY.
- Java использует свою переменную http.nonProxyHosts с синтаксисом wildcards вида *.svc.cluster.local и разделителем вертикальной чертой.
Практический вывод: если в кластере зоопарк языков, единственный надёжный способ исключить внутренний трафик по CIDR — не полагаться на NO_PROXY клиента, а решать это на уровне sidecar или шлюза, где парсер под вашим контролем. Для DNS-имён суффиксы с точкой работают почти везде, поэтому в приложениях стоит ходить к сервисам по именам, а не по ClusterIP.
Регистр переменных
Ещё один момент, который регулярно стоит часов отладки. curl читает http_proxy только в нижнем регистре: заглавная HTTP_PROXY им игнорируется намеренно, из-за исторической уязвимости с CGI. При этом HTTPS_PROXY и NO_PROXY curl принимает в обоих регистрах. Go, Python и .NET читают оба варианта. Поэтому в манифесте мы всегда задаём обе формы — это дёшево и снимает целый класс проблем.
Рабочий фрагмент: ConfigMap с NO_PROXY и Deployment
Вынесите NO_PROXY в ConfigMap уровня неймспейса. Так вы меняете список в одном месте, а не в двадцати Deployment:
apiVersion: v1
kind: ConfigMap
metadata:
 name: egress-proxy-common
 namespace: crawlers
data:
 NO_PROXY: "localhost,127.0.0.1,::1,.svc,.svc.cluster.local,.cluster.local,kubernetes.default.svc,10.96.0.0/12,10.244.0.0/16,192.168.10.0/24,169.254.169.254,.corp.local"
 no_proxy: "localhost,127.0.0.1,::1,.svc,.svc.cluster.local,.cluster.local,kubernetes.default.svc,10.96.0.0/12,10.244.0.0/16,192.168.10.0/24,169.254.169.254,.corp.local"
И Deployment, который его использует. Адрес прокси здесь пока без кредов — как хранить креды, разберём в отдельном разделе:
apiVersion: apps/v1
kind: Deployment
metadata:
 name: price-collector
 namespace: crawlers
spec:
 replicas: 3
 selector:
matchLabels:
 app: price-collector
 template:
metadata:
 labels:
app: price-collector
spec:
 containers:
 - name: app
image: registry.internal/price-collector:2.7.0
envFrom:
- configMapRef:
name: egress-proxy-common
env:
- name: HTTP_PROXY
 value: "http://proxy-host.example:8080"
- name: http_proxy
 value: "http://proxy-host.example:8080"
- name: HTTPS_PROXY
 value: "http://proxy-host.example:8080"
- name: https_proxy
 value: "http://proxy-host.example:8080"
readinessProbe:
 httpGet:
path: /healthz
port: 8080
Обратите внимание на схему в HTTPS_PROXY: чаще всего это http://, потому что к самому прокси клиент подключается по обычному TCP, а уже внутри устанавливает туннель CONNECT для HTTPS-запросов. Значение https:// здесь означает TLS до самого прокси, что поддерживают далеко не все клиенты и не все прокси-сервера. Уточните в панели Proxeon, какой тип подключения предоставляет ваш тариф.
Проверьте, что проба не ходит через прокси
Liveness и readiness пробы выполняет kubelet, а не приложение, поэтому они переменных окружения не видят и проксирование им не страшно. Но если ваше приложение внутри обработчика /healthz само вызывает зависимости по внутренним адресам, эти вызовы попадут под HTTP_PROXY. Именно так выглядит классический симптом «после добавления прокси поды перестали проходить readiness».
Что НЕ подхватывает эти переменные: kubelet, образы с собственной конфигурацией, SDK
Переменные окружения пода живут внутри процесса приложения. Всё, что находится за его пределами или намеренно игнорирует окружение, требует отдельной настройки. Разберём три группы.
Kubelet и container runtime
Самый частый вопрос при переезде кластера за прокси: «почему образы не тянутся, мы же прописали HTTP_PROXY в Deployment». Ответ: образы скачивает не под, а container runtime (containerd или CRI-O) на ноде по команде kubelet. Это системные сервисы, запущенные через systemd, и они читают только своё окружение.
Настройка делается drop-in файлом для systemd-юнита на каждой ноде. Для containerd это выглядит так (файл /etc/systemd/system/containerd.service.d/http-proxy.conf):
[Service]
Environment="HTTP_PROXY=http://proxy-host.example:8080"
Environment="HTTPS_PROXY=http://proxy-host.example:8080"
Environment="NO_PROXY=localhost,127.0.0.1,10.96.0.0/12,10.244.0.0/16,192.168.10.0/24,.svc,.cluster.local,registry.internal"
После этого — systemctl daemon-reload и systemctl restart containerd. В NO_PROXY обязательно должен попасть внутренний registry, иначе runtime пойдёт за вашими же образами через внешний прокси. Для kubelet отдельный drop-in нужен реже — только если он сам обращается к облачным API или внешним вебхукам.
В managed-кластерах доступа к нодам может не быть, и тогда настройка runtime делается через механизмы провайдера облака или через DaemonSet с привилегированным контейнером, который правит конфигурацию на хосте. Второй вариант — компромисс, который стоит согласовывать с командой безопасности.
Образы с собственной конфигурацией
Многие готовые образы приносят конфигурационный файл, который переопределяет или игнорирует окружение:
- JVM-приложения. Java не читает HTTP_PROXY. Нужны системные свойства. Удобно передавать их через JAVA_TOOL_OPTIONS, которую JVM подхватывает без правки скриптов запуска:
env:
- name: JAVA_TOOL_OPTIONS
value: "-Dhttp.proxyHost=proxy-host.example -Dhttp.proxyPort=8080 -Dhttps.proxyHost=proxy-host.example -Dhttps.proxyPort=8080 -Dhttp.nonProxyHosts=localhost|127.0.0.1|*.svc|*.svc.cluster.local|*.cluster.local|10.*|192.168.*"- Образы с собственным конфигом HTTP-клиента (некоторые агенты мониторинга, коннекторы, ETL-инструменты) читают прокси из своего YAML или TOML. Окружение они видят, но не используют. Читайте документацию образа и ищите ключи вида proxy_url.
- Образы с жёстко заданным DNS-резолвером внутри приложения ломают саму идею NO_PROXY по именам: приложение резолвит имя само, получает IP и уже IP сравнивает со списком, где у вас только доменные суффиксы.
- Скрипты entrypoint, которые переопределяют переменные. Встречается реже, но проверить стоит: kubectl exec pod -- cat /proc/1/environ | tr нулевой байт в перенос покажет реальное окружение главного процесса.
Отдельные SDK и протоколы
Здесь список длинный, приведём самое частое:
- gRPC. Многие реализации поддерживают HTTP_PROXY только через CONNECT и с ограничениями; часть игнорирует NO_PROXY. Для gRPC-трафика внутри кластера это опасно вдвойне.
- Node.js. Встроенный fetch и модуль http/https не читают окружение. Нужен явный агент. Библиотека axios читает HTTP_PROXY через свою зависимость, а вот нативный fetch — нет. В одном приложении два клиента могут вести себя по-разному.
- Облачные SDK. Большинство уважает HTTP_PROXY, но обращение к endpoint метаданных (169.254.169.254) должно быть в исключениях, иначе получение временных учётных данных сломается.
- WebSocket и raw TCP. Клиенты баз данных, брокеров сообщений, Redis работают по своим протоколам поверх TCP и через HTTP-прокси не проходят вовсе. Если такой трафик обязан идти через прокси, нужен SOCKS-режим или транспарентный перехват на уровне sidecar.
- Собственные DNS-клиенты в приложениях (resolve через отдельную библиотеку) не взаимодействуют с прокси и ходят напрямую по UDP 53. Это нормально, но об этом надо помнить при написании NetworkPolicy.
Вывод раздела: прежде чем выкатывать прокси на сервис, составьте карту его исходящих соединений по протоколам и библиотекам. Полчаса с инвентаризацией экономят день отладки.
Секреты: креды прокси через Secret, а не в манифест
Адрес прокси с логином и паролем в теле Deployment — это утечка, ожидающая своего часа. Манифесты живут в git, попадают в CI-логи, отображаются в kubectl get deploy -o yaml любому с правами на чтение неймспейса. Давайте сделаем правильно.
Вариант 1: полный URL прокси в Secret
Самая простая схема: в Secret хранится готовая строка с кредами, приложение получает её как переменную окружения. Секрет создаём вне git (через CI-переменные, внешний менеджер секретов или вручную):
kubectl -n crawlers create secret generic egress-proxy-creds --from-literal=HTTP_PROXY="http://user123:s3cretPass@proxy-host.example:8080" --from-literal=HTTPS_PROXY="http://user123:s3cretPass@proxy-host.example:8080" --from-literal=http_proxy="http://user123:s3cretPass@proxy-host.example:8080" --from-literal=https_proxy="http://user123:s3cretPass@proxy-host.example:8080"В Deployment вместо явных env — ссылка на Secret и на ConfigMap с NO_PROXY:
containers:
- name: app
 image: registry.internal/price-collector:2.7.0
 envFrom:
 - configMapRef:
 name: egress-proxy-common
 - secretRef:
 name: egress-proxy-creds
Важная деталь: если логин или пароль содержат спецсимволы (@, :, /, %), их нужно URL-кодировать. Пароль с символом @ без кодирования разорвёт разбор URL, и клиент попытается подключиться не к тому хосту. В панели Proxeon при генерации доступов удобно сразу выбирать пароль без спецсимволов или копировать готовый URL.
Вариант 2: раздельные поля и сборка URL в контейнере
Когда логин и пароль хранятся отдельно (например, синхронизируются из внешнего хранилища секретов), URL собирается в entrypoint или в самом приложении:
env:
- name: PROXY_USER
 valueFrom:
secretKeyRef:
 name: egress-proxy-creds
 key: username
- name: PROXY_PASS
 valueFrom:
secretKeyRef:
 name: egress-proxy-creds
 key: password
- name: PROXY_HOST
 value: "proxy-host.example:8080"
Такой вариант удобнее для ротации пароля: меняется один ключ Secret, а не четыре готовые строки.
Вариант 3: файл вместо переменной
Переменные окружения процесса читаются из /proc и часто попадают в crash-дампы и отчёты об ошибках. Если политика безопасности строгая, монтируйте Secret как файл с правами 0400 и читайте его в приложении или в sidecar:
volumes:
- name: proxy-creds
 secret:
secretName: egress-proxy-creds
defaultMode: 0400
containers:
- name: app
 volumeMounts:
 - name: proxy-creds
mountPath: /var/run/secrets/proxy
readOnly: true
Вариант 4: убрать креды вообще
Если у вас egress-шлюз со стабильным исходящим IP, авторизацию на прокси можно перевести с логина и пароля на белый список IP. В этом случае в кластере вообще не хранится ничего секретного: поды ходят на внутренний Service шлюза, шлюз выходит с фиксированного адреса, провайдер пропускает трафик по адресу. Proxeon поддерживает оба режима авторизации, и для кластера с выделенным egress мы обычно рекомендуем именно IP-режим как более безопасный и простой в эксплуатации.
Гигиена вокруг Secret
- Включите шифрование Secret at rest в etcd — по умолчанию оно выключено в большинстве самостоятельных установок.
- Ограничьте RBAC: право на чтение секретов неймспейса должно быть только у сервис-аккаунтов, которым оно реально нужно. Приложение, получающее секрет через envFrom, читать объект Secret через API не должно.
- Не логируйте окружение. Проверьте, что фреймворк не выводит env при старте в debug-режиме.
- Договоритесь о ротации. Смена пароля прокси должна быть штатной операцией: обновили Secret, сделали rollout restart, старый пароль отключили.
- Учитывайте, что при использовании envFrom обновление Secret не меняет окружение уже запущенных подов. Нужен rollout restart. При монтировании файлом kubelet обновит содержимое за минуту-две, но приложение должно уметь перечитывать файл.
Sidecar-подход: когда оправдан и что даёт помимо прокси
Sidecar в контексте egress — это локальный прокси-контейнер в поде, который принимает трафик приложения и отправляет его дальше через внешний прокси. Он превращает вопрос «уважает ли библиотека HTTP_PROXY» в вопрос «умеет ли sidecar перехватывать трафик», и на второй вопрос ответить проще.
Когда sidecar оправдан
- Приложение написано на стеке, где управление прокси неудобно (JVM с десятком разных клиентов, Node.js со смесью fetch и axios, легаси на C++).
- Нужна ротация адресов по расписанию или по ошибкам без правки кода: sidecar держит пул из нескольких прокси Proxeon и переключается сам.
- Хотите вынести креды из приложения: sidecar единственный, кто знает пароль, а приложение ходит на localhost без авторизации.
- Нужна единая политика повторов, таймаутов и лимитов запросов на внешний мир для сервиса.
- Требуется трафик не только HTTP: SOCKS-режим или транспарентный TCP-перехват.
Когда sidecar избыточен
- Один сервис на Go или Python с одним HTTP-клиентом. Переменных окружения хватит.
- Жёсткие лимиты по ресурсам: тысячи мелких подов, где лишние 30–50 МБ на sidecar умножаются в тонны памяти.
- Уже есть egress-шлюз с нужной логикой, и дублировать её в каждом поде нет смысла.
Нативные sidecar-контейнеры
С версии Kubernetes 1.29 появился и к 1.33 стабилизировался механизм нативных sidecar: init-контейнер с restartPolicy: Always. Такой контейнер стартует до основного, живёт всё время жизни пода и корректно завершается после основного. Это решает старую боль: раньше приложение могло стартовать раньше прокси и получить connection refused на первых запросах, а Job с sidecar никогда не завершался, потому что sidecar продолжал работать.
Рабочий фрагмент: под с sidecar-прокси
Здесь sidecar — небольшой форвард-прокси (условный образ egress-sidecar), который слушает на 127.0.0.1:3128, читает креды upstream из Secret и знает, какие адреса пускать напрямую:
apiVersion: apps/v1
kind: Deployment
metadata:
 name: feed-importer
 namespace: integrations
spec:
 replicas: 2
 selector:
matchLabels:
 app: feed-importer
 template:
metadata:
 labels:
app: feed-importer
spec:
 initContainers:
 - name: egress-sidecar
image: registry.internal/egress-sidecar:1.3.0
restartPolicy: Always
env:
- name: LISTEN_ADDR
 value: "127.0.0.1:3128"
- name: DIRECT_CIDRS
 value: "10.96.0.0/12,10.244.0.0/16,192.168.10.0/24"
- name: DIRECT_SUFFIXES
 value: ".svc,.cluster.local,.corp.local"
envFrom:
- secretRef:
name: egress-upstream-creds
resources:
 requests:
cpu: 20m
memory: 32Mi
 limits:
memory: 96Mi
readinessProbe:
 tcpSocket:
port: 3128
 containers:
 - name: app
image: registry.internal/feed-importer:4.1.0
envFrom:
- configMapRef:
name: egress-proxy-common
env:
- name: HTTP_PROXY
 value: "http://127.0.0.1:3128"
- name: HTTPS_PROXY
 value: "http://127.0.0.1:3128"
- name: http_proxy
 value: "http://127.0.0.1:3128"
- name: https_proxy
 value: "http://127.0.0.1:3128"
Обратите внимание: NO_PROXY у приложения всё ещё нужен. Sidecar умеет пускать внутренний трафик напрямую, но зачем гонять его через лишний хоп на localhost? Кроме того, разбор CIDR в sidecar под вашим контролем, а в приложении — нет. Двойная защита здесь уместна.
Транспарентный режим через iptables
Если приложение игнорирует окружение полностью, добавляется init-контейнер, который перенаправляет весь исходящий TCP-трафик пода, кроме внутренних сетей и трафика самого sidecar, на порт sidecar. Sidecar при этом должен работать в режиме транспарентного прокси и восстанавливать оригинальный адрес назначения. Init-контейнеру нужна capability NET_ADMIN, а sidecar должен работать под отдельным UID, чтобы его собственный трафик не зациклился:
initContainers:
- name: egress-redirect
 image: registry.internal/egress-init:1.0.0
 securityContext:
capabilities:
 add: ["NET_ADMIN"]
 command: ["sh", "-c"]
 args:
 - |
iptables -t nat -N EGRESS_REDIRECT
iptables -t nat -A EGRESS_REDIRECT -d 10.96.0.0/12 -j RETURN
iptables -t nat -A EGRESS_REDIRECT -d 10.244.0.0/16 -j RETURN
iptables -t nat -A EGRESS_REDIRECT -d 127.0.0.0/8 -j RETURN
iptables -t nat -A EGRESS_REDIRECT -m owner --uid-owner 1337 -j RETURN
iptables -t nat -A EGRESS_REDIRECT -p tcp -j REDIRECT --to-ports 15001
iptables -t nat -A OUTPUT -p tcp -j EGRESS_REDIRECT
Здесь 1337 — UID, под которым запущен sidecar, а 15001 — его транспарентный порт. Это тот же принцип, который используют service mesh для перехвата трафика. Если в кластере уже стоит mesh, скорее всего, его egress-возможностей хватит и отдельный sidecar не нужен.
Что sidecar даёт помимо прокси
- Метрики исходящего трафика в разрезе хоста назначения, кода ответа, времени: приложение о них не знает, а sidecar видит всё.
- Circuit breaker на внешние API: при серии ошибок sidecar перестаёт долбить партнёра и отдаёт быстрый отказ.
- Пул адресов и ротация: список прокси Proxeon в конфиге, переключение по стратегии round-robin или по ошибке 407/403.
- Локальный кэш DNS для внешних имён, снижающий нагрузку на CoreDNS.
- Ограничение скорости per-destination, чтобы соблюдать лимиты партнёрских API и не попадать под их ограничения.
Egress-шлюз кластера: единая точка выхода
Egress-шлюз решает задачу другого масштаба: не «как этому сервису ходить через прокси», а «через какие адреса кластер вообще выходит в мир». Рассмотрим практичную реализацию без привязки к конкретному CNI.
Архитектура
- Выделяется группа нод с фиксированными внешними IP (в облаке — с закреплённым публичным адресом или за отдельным NAT-шлюзом). Ноды получают метку node-role: egress и taint, чтобы на них не селились посторонние поды.
- На этих нодах разворачивается Deployment форвард-прокси с несколькими репликами и anti-affinity. Перед ним — Service типа ClusterIP.
- Прикладные поды получают HTTP_PROXY, указывающий на этот Service. Их NO_PROXY содержит внутренние сети.
- NetworkPolicy запрещает прикладным подам любой egress за пределы кластера, кроме DNS и трафика к Service шлюза.
- Шлюз сам ходит наружу либо напрямую (тогда его IP и есть исходящий адрес кластера), либо через внешний прокси Proxeon с авторизацией по IP шлюза.
Рабочий фрагмент: Deployment шлюза и NetworkPolicy
apiVersion: apps/v1
kind: Deployment
metadata:
 name: egress-gateway
 namespace: egress
spec:
 replicas: 3
 selector:
matchLabels:
 app: egress-gateway
 template:
metadata:
 labels:
app: egress-gateway
spec:
 nodeSelector:
node-role: egress
 tolerations:
 - key: dedicated
value: egress
effect: NoSchedule
 affinity:
podAntiAffinity:
 requiredDuringSchedulingIgnoredDuringExecution:
 - labelSelector:
 matchLabels:
app: egress-gateway
topologyKey: kubernetes.io/hostname
 containers:
 - name: proxy
image: registry.internal/egress-gateway:2.0.1
ports:
- containerPort: 3128
envFrom:
- secretRef:
name: egress-upstream-creds
---
apiVersion: v1
kind: Service
metadata:
 name: egress-gateway
 namespace: egress
spec:
 selector:
app: egress-gateway
 ports:
 - port: 3128
targetPort: 3128
Политика для прикладного неймспейса, которая закрывает прямой выход в интернет:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
 name: egress-only-via-gateway
 namespace: crawlers
spec:
 podSelector: {}
 policyTypes: ["Egress"]
 egress:
 - to:
- namespaceSelector:
matchLabels:
 kubernetes.io/metadata.name: kube-system
ports:
- protocol: UDP
 port: 53
- protocol: TCP
 port: 53
 - to:
- namespaceSelector:
matchLabels:
 kubernetes.io/metadata.name: egress
 podSelector:
matchLabels:
 app: egress-gateway
ports:
- protocol: TCP
 port: 3128
 - to:
- ipBlock:
cidr: 10.244.0.0/16
- ipBlock:
cidr: 10.96.0.0/12
Такая политика превращает шлюз из рекомендации в обязательство: под с забытым HTTP_PROXY не выйдет наружу мимо него, а просто получит таймаут. Это обнаруживается на тестовом стенде за минуты, а не в продакшене за недели.
Отказоустойчивость и ёмкость
- Минимум три реплики на разных нодах и PodDisruptionBudget с minAvailable: 2.
- Мониторинг соединений: количество открытых, время установки CONNECT, доля 5xx от upstream.
- Лимит на количество одновременных соединений от одного клиентского пода, чтобы один сбойный сервис не забил шлюз.
- Учёт conntrack на нодах шлюза: при десятках тысяч соединений в секунду таблица переполняется, и вы получите загадочные потери пакетов. Увеличивайте nf_conntrack_max заранее.
Диагностика в кластере: как проверить исходящий IP из пода и где смотреть отказы
Прокси-проблемы в кластере коварны тем, что симптом появляется далеко от причины. Ниже — методика, которая позволяет за несколько шагов локализовать сбой.
Шаг 1: убедитесь, что окружение действительно применилось
kubectl -n crawlers exec deploy/price-collector -- env | grep -i proxyИщите обе формы регистра, полноту NO_PROXY, отсутствие лишних пробелов. Если приложение запускается через entrypoint-скрипт, дополнительно проверьте окружение главного процесса через /proc/1/environ — оно может отличаться от того, что показывает exec, запускающий новую оболочку.
Шаг 2: проверьте исходящий IP
Разверните в кластере или на внешнем хосте компании простой эхо-сервис, который возвращает адрес клиента и заголовки. Затем из пода:
kubectl -n crawlers exec deploy/price-collector -- curl -s https://echo.yourcompany.example/ip
kubectl -n crawlers exec deploy/price-collector -- curl -s --noproxy '*' https://echo.yourcompany.example/ip
Первая команда идёт по правилам окружения, вторая принудительно мимо прокси. Если адреса совпадают — прокси не используется. Если первая возвращает IP прокси-провайдера, а вторая — IP ноды или облачного NAT, схема работает. Это также единственный надёжный способ убедиться, что вы видите именно тот адрес, который выдала панель Proxeon, а не адрес ноды.
Шаг 3: посмотрите на диалог с прокси глазами клиента
kubectl -n crawlers exec deploy/price-collector -- curl -sv https://api.partner.example/status 2>&1 | head -30В выводе ищите строку с CONNECT и код ответа прокси на неё. Типовые сигналы:
- 407 Proxy Authentication Required — креды не дошли или неверны. Проверьте URL-кодирование пароля и то, что прокси ожидает именно Basic-авторизацию.
- 403 от прокси на CONNECT — целевой хост или порт запрещён политикой прокси, либо ваш IP не в белом списке при IP-авторизации.
- 502/503 на CONNECT — прокси не смог достучаться до цели. Если цель внутренняя — это диагноз «дыра в NO_PROXY».
- Connection refused к самому прокси — неверный адрес, порт или NetworkPolicy не пропускает трафик к шлюзу.
- Таймаут без ответа — чаще всего сетевая политика или отсутствующий маршрут. Проверьте, что DNS вообще разрешается.
Шаг 4: проверьте внутрикластерные вызовы
kubectl -n crawlers exec deploy/price-collector -- curl -sv http://payments.default.svc.cluster.local:8080/healthz 2>&1 | grep -iE "connected|proxy|HTTP/"Если в выводе есть обращение к прокси, а не прямое соединение с ClusterIP, значит NO_PROXY не покрыл этот адрес. Повторите то же для короткого имени payments и для IP сервиса — все три должны идти напрямую.
Шаг 5: ephemeral-контейнер для образов без инструментов
В минимальных образах нет ни curl, ни nslookup. Используйте kubectl debug, который подключит отладочный контейнер в сетевое пространство пода:
kubectl -n crawlers debug -it pod/price-collector-7d9f4-x2k8q --image=registry.internal/netdebug:latest --target=app -- shВнутри доступны те же IP, тот же resolv.conf и тот же sidecar на localhost. Только окружение приложения сюда не наследуется: переменные проверяйте через /proc/PID/environ основного процесса.
Шаг 6: логи и события
- Логи sidecar или шлюза: коды ответов upstream, время CONNECT, к каким хостам обращались. Именно здесь видна попытка отправить внутренний адрес наружу.
- События пода: kubectl describe pod покажет ImagePullBackOff — признак того, что container runtime за прокси не настроен или registry не в его NO_PROXY.
- Логи CoreDNS в режиме debug: всплеск NXDOMAIN по внешним именам говорит о том, что приложение резолвит внешние хосты само, хотя должно отдавать их прокси.
- Метрики conntrack на нодах egress: рост nf_conntrack_count к лимиту — предвестник потерь.
Шаг 7: разделяйте проблему прокси и проблему цели
Один и тот же 403 может прийти от прокси и от целевого сайта. Отличить помогает заголовок Via или специфичные заголовки провайдера в ответе, а также сравнение с запросом через --noproxy. Если через прокси 403, а напрямую 200 — вопрос к настройкам прокси или к тому, что целевой ресурс ограничивает трафик с адресов данного пула. Если 403 в обоих случаях — проблема в самом запросе.
Типичные ошибки
Соберём вместе грабли, на которые наступают чаще всего. Многие из них мы уже разобрали, здесь — сводка для быстрой проверки.
- NO_PROXY скопирован с сервера. Значение localhost,127.0.0.1 в кластере гарантированно ломает сервисное общение. Нужны .svc, .cluster.local, service и pod CIDR.
- Ставка на CIDR в NO_PROXY у Python или старого curl. Библиотека молча игнорирует запись, трафик к ClusterIP идёт через прокси. Ходите по DNS-именам и используйте суффиксы.
- Только заглавные переменные. curl не читает HTTP_PROXY в верхнем регистре. Задавайте обе формы.
- Креды в манифесте. Пароль в git и в выводе kubectl get -o yaml. Только Secret, лучше IP-авторизация через шлюз.
- Пароль со спецсимволами без URL-кодирования. Клиент разбирает URL неправильно, вы получаете connection refused к несуществующему хосту.
- Ожидание, что kubelet и containerd подхватят env пода. Образы не тянутся, все идут искать проблему в Deployment, а нужен systemd drop-in на нодах.
- Забытый registry в NO_PROXY runtime. Внутренний registry становится недоступен, потому что containerd пошёл за ним через внешний прокси.
- Java с HTTP_PROXY. JVM не читает эти переменные. Нужны системные свойства через JAVA_TOOL_OPTIONS.
- Sidecar как обычный контейнер, а не нативный init с restartPolicy: Always. Приложение стартует раньше прокси и падает на первых запросах, Job никогда не завершается.
- Egress-шлюз без NetworkPolicy. Шлюз есть, но половина подов ходит мимо него, и вы узнаёте об этом, когда партнёр присылает список неизвестных IP.
- Обновили Secret и не сделали rollout restart. Старые поды продолжают работать со старым паролем, который вы уже отключили в панели.
- Игнорирование метаданных облака. 169.254.169.254 не в NO_PROXY — облачный SDK не может получить временные ключи, и приложение падает загадочными ошибками авторизации.
- Перегрузка одного адреса прокси всеми репликами. Тридцать реплик долбят один выходной адрес, партнёрский API отвечает лимитами. Распределяйте нагрузку по пулу адресов через sidecar или шлюз.
Инструменты и ресурсы
Набор, который стоит держать под рукой при работе с исходящим трафиком в кластере.
Встроенные инструменты Kubernetes
- kubectl exec и kubectl debug — проверка окружения и сетевых соединений внутри пода, включая ephemeral-контейнеры для минимальных образов.
- kubectl describe pod и события — ImagePullBackOff, отказы проб, ошибки монтирования секретов.
- NetworkPolicy — принуждение к выходу через шлюз и тестирование гипотез «кто ходит мимо».
- Нативные sidecar-контейнеры (restartPolicy: Always в initContainers) — корректный жизненный цикл прокси-помощника.
Сетевая диагностика
- Отладочный образ с curl, dig, tcpdump, ss, iptables — соберите свой на базе минимального дистрибутива и держите в внутреннем registry.
- Собственный эхо-сервис, возвращающий IP клиента и заголовки, — самый честный способ увидеть исходящий адрес.
- tcpdump на ноде с фильтром по IP пода — когда нужно точно увидеть, к какому адресу открывается соединение.
- Логи CoreDNS в debug-режиме — для понимания, кто и что резолвит.
Управление секретами и конфигурацией
- Внешний менеджер секретов с синхронизацией в Secret кластера — чтобы креды прокси не жили в git и ротировались централизованно.
- Kustomize или Helm с общим ConfigMap для NO_PROXY — единая правда для всех Deployment неймспейса.
- Политики допуска (admission-контроллеры), проверяющие наличие NO_PROXY в каждом поде с HTTP_PROXY — автоматическая защита от копипаста «с сервера».
Провайдер прокси
Со стороны прокси важны три вещи: возможность авторизации по IP (для схемы со шлюзом), стабильные адреса с понятным сроком закрепления и API для управления доступами, чтобы ротацию паролей можно было автоматизировать из CI. В Proxeon эти механизмы есть в панели и через API, что позволяет встроить провайдера в GitOps-процесс вместо ручного копирования строк подключения.
Кейсы и результаты
Кейс 1: ETL-платформа и «сломанные» внутренние сервисы
Команда данных добавила HTTP_PROXY в двадцать Deployment, чтобы сборщики каталогов маркетплейсов ходили через выделенные адреса. NO_PROXY скопировали из документации к серверу: localhost и 127.0.0.1. В течение часа доля 5xx между внутренними сервисами выросла с 0,1% до 34%, readiness-пробы трёх сервисов начали флапать. После добавления .svc, .cluster.local и обоих CIDR в общий ConfigMap и rollout restart ошибки ушли за пять минут. Дополнительный эффект: перенос NO_PROXY в ConfigMap сократил время следующего изменения списка с полудня (правка двадцати манифестов) до одного коммита.
Кейс 2: JVM-интеграции и sidecar
Финансовый интегратор на Java с семью разными HTTP-клиентами внутри одного приложения (часть — через библиотеки, которые не читают системные свойства прокси). Попытка настроить всё через JAVA_TOOL_OPTIONS покрыла пять клиентов из семи. Решение — нативный sidecar с транспарентным перехватом через iptables. Все семь клиентов пошли через прокси без изменений кода, креды исчезли из приложения, а метрики исходящего трафика появились впервые за историю сервиса. Стоимость: 40 МБ памяти на под, что при двенадцати репликах оказалось несущественно.
Кейс 3: egress-шлюз и авторизация по IP
Кластер из шестидесяти нод с автоскейлингом обращался к нескольким партнёрским API, требующим белого списка IP. Каждое масштабирование нод меняло набор исходящих адресов, партнёры блокировали трафик. Развернули egress-шлюз на трёх выделенных нодах с закреплёнными адресами, ввели NetworkPolicy во всех прикладных неймспейсах, авторизацию на прокси Proxeon перевели на IP-режим. Итог: количество инцидентов «нас снова заблокировал партнёр» упало с трёх-четырёх в месяц до нуля за квартал, а из кластера исчезли все Secret с паролями прокси. Побочный результат: централизованные логи шлюза выявили два сервиса, которые ходили к внешним API, о которых никто не знал.
Кейс 4: containerd и загадочный ImagePullBackOff
После переезда кластера в сеть с обязательным прокси поды с прописанным HTTP_PROXY работали, но новые ноды не могли скачать ни один образ. Причина — отсутствие drop-in для containerd. После добавления файла с прокси и внутренним registry в NO_PROXY проблема решена. Урок оформили как проверку в bootstrap-скрипте нод: перед присоединением к кластеру нода проверяет, что containerd может скачать тестовый образ из внутреннего и внешнего registry.
Чеклист выката
Пройдите по списку перед тем, как выкатывать прокси на продакшен-сервис. Каждый пункт — это чей-то ночной инцидент.
Подготовка
- Составлена карта исходящих соединений сервиса: внешние хосты, внутренние сервисы, базы, очереди, облачные endpoint, протоколы.
- Известны service CIDR, pod CIDR, node CIDR кластера и внутренние домены компании.
- Проверено, какие HTTP-клиенты использует приложение и как каждый из них трактует NO_PROXY (CIDR, суффиксы, регистр).
- Выбран уровень: контейнер, sidecar или шлюз. Решение задокументировано.
Конфигурация
- NO_PROXY вынесен в ConfigMap неймспейса и содержит: localhost, 127.0.0.1, .svc, .svc.cluster.local, .cluster.local, kubernetes.default.svc, service CIDR, pod CIDR, 169.254.169.254, внутренние домены.
- Переменные заданы в обоих регистрах.
- Креды только в Secret; пароль URL-кодирован; RBAC на секреты ограничен.
- Для JVM задан JAVA_TOOL_OPTIONS с nonProxyHosts.
- Если sidecar — он нативный (initContainers с restartPolicy: Always), с readinessProbe и лимитами ресурсов.
- Если шлюз — минимум три реплики, anti-affinity, PDB, NetworkPolicy в прикладных неймспейсах.
- Container runtime на нодах настроен отдельно; внутренний registry в его NO_PROXY.
Проверка на стенде
- env внутри пода показывает ожидаемые значения.
- Запрос к эхо-сервису возвращает адрес прокси; с --noproxy — адрес ноды.
- Запросы к внутренним сервисам по короткому имени, полному имени и ClusterIP идут напрямую (видно в curl -v).
- Readiness и liveness проходят стабильно в течение как минимум десяти минут.
- Клиент API Kubernetes (если есть) видит control plane.
- Логи sidecar или шлюза не содержат обращений к внутренним адресам.
Выкат и после
- Поэтапный rollout с maxUnavailable не выше 25%; мониторинг 5xx между сервисами и ошибок 407/403 от прокси.
- Задокументирована процедура ротации пароля: обновление Secret, rollout restart, отключение старого доступа.
- Настроены алерты на рост доли ошибок от прокси и на приближение conntrack к лимиту на egress-нодах.
- Через неделю — ревизия логов шлюза: не появилось ли неожиданных внешних адресатов.
FAQ
Можно ли задать HTTP_PROXY глобально для всего кластера, а не в каждом Deployment?
Прямого механизма нет: переменные окружения — часть спецификации пода. Практические варианты — общий ConfigMap с envFrom во всех манифестах через Helm или Kustomize, либо mutating admission-контроллер, который автоматически добавляет переменные в поды с определённой аннотацией. Второй способ мощнее, но требует аккуратности: он же должен добавлять и NO_PROXY, иначе автоматизация будет массово ломать сервисы.
Почему curl в поде идёт через прокси, а приложение на Python — нет, хотя окружение одно?
Скорее всего, дело в регистре или в разборе NO_PROXY. curl читает http_proxy только в нижнем регистре, Python — в обоих. С другой стороны, Python не понимает CIDR в NO_PROXY, а свежий curl понимает. Проверьте обе гипотезы: задайте переменные в обоих регистрах и используйте доменные суффиксы вместо CIDR.
Нужен ли NO_PROXY, если весь внутренний трафик и так идёт через sidecar с правилами direct?
Технически можно обойтись без него, но мы рекомендуем оставить. Во-первых, лишний хоп через localhost для тысяч внутренних запросов — это ненулевые задержки и нагрузка на sidecar. Во-вторых, если sidecar упадёт или перезапустится, приложение с корректным NO_PROXY продолжит общаться с внутренними сервисами, а без него — потеряет вообще всё.
Как понять, что запрос к партнёру ушёл именно с адреса прокси, а не с адреса ноды?
Единственный надёжный способ — контрольный запрос к эхо-сервису, который возвращает IP клиента, из того же пода и с тем же окружением. Сравните ответ с адресом, который отображается в панели Proxeon для вашего доступа, и с ответом при --noproxy. Логи самого партнёра тоже помогут, но их обычно нет под рукой.
Стоит ли шифровать соединение до прокси (схема https:// в HTTPS_PROXY)?
Для HTTPS-трафика к целевым сайтам содержимое уже зашифровано end-to-end внутри CONNECT-туннеля, прокси видит только хост назначения. TLS до прокси защищает креды авторизации и имена хостов на участке от пода до прокси. Если этот участок проходит по недоверенной сети, TLS до прокси оправдан, но убедитесь, что и клиент, и прокси его поддерживают: часть библиотек схему https:// в HTTPS_PROXY игнорирует. Внутри кластера между подом и egress-шлюзом обычно достаточно сетевых политик.
Что делать с трафиком баз данных и брокеров, который должен выходить за пределы кластера?
Через HTTP-прокси он не пройдёт — это не HTTP. Варианты: SOCKS5-режим прокси, если провайдер и клиентская библиотека его поддерживают; транспарентный перехват на уровне sidecar с TCP-туннелированием; или egress-шлюз, который работает на уровне маршрутизации, а не протокола. Выбор зависит от того, нужен ли вам именно определённый внешний IP или достаточно централизованного выхода.
Можно ли использовать один и тот же прокси для containerd и для приложений?
Технически да, но обычно это разные задачи. Runtime тянет образы из публичных registry, и ему нужен прокси корпоративного периметра. Приложения ходят к партнёрским API, и им нужны выделенные адреса с определёнными свойствами. Смешивание приводит к тому, что скачивание образов расходует лимиты трафика, предназначенные для прикладных задач. Разделяйте.
Как безопасно менять пароль прокси без даунтайма?
Заведите второй доступ у провайдера, обновите Secret на новые креды, выполните rollout restart с поэтапным обновлением реплик, убедитесь по логам, что 407 нет, и только затем отключите старый доступ. Если используете IP-авторизацию через шлюз, ротация паролей вообще исчезает из вашего списка задач.
Как ограничить, чтобы прокси использовался только для конкретных внешних доменов?
NO_PROXY работает наоборот — он описывает, куда прокси не ходить, и белый список на его основе не построить. Такая логика реализуется в sidecar или шлюзе: правила вида «домены из списка A — через пул адресов Proxeon, всё остальное — напрямую или запрет». Плюс NetworkPolicy, чтобы прямой выход в интернет физически не существовал.
Заключение
Исходящий трафик в Kubernetes отличается от серверного не деталями, а самой структурой: у каждого пода два мира — внутренний и внешний, и прокси должен видеть только второй. Отсюда вытекает всё остальное. NO_PROXY превращается из формальности в архитектурный элемент, который обязан описывать всю внутреннюю сеть кластера и учитывать, что разные библиотеки трактуют его по-разному. Переменные окружения работают только внутри процесса — kubelet, container runtime и упрямые SDK требуют отдельного внимания. Креды не должны попадать в манифесты, а в идеале — вообще исчезнуть из кластера благодаря шлюзу с IP-авторизацией.
Три уровня встраивания прокси — контейнер, sidecar, egress-шлюз — это не конкуренты, а инструменты для разных задач. Контейнерный уровень быстр и гранулярен. Sidecar снимает зависимость от поведения библиотек и добавляет метрики, ротацию, повторы. Шлюз даёт кластеру предсказуемое лицо во внешнем мире и делает выход через прокси не рекомендацией, а правилом, которое подкреплено сетевыми политиками.
Что делать дальше? Начните с инвентаризации: соберите карту исходящих соединений ваших сервисов и посмотрите, сколько из них внутренние. Затем вынесите NO_PROXY в общий ConfigMap и проверьте его на стенде по методике из раздела диагностики. Если в кластере больше одного стека или есть требования к стабильным адресам — спроектируйте egress-шлюз и подключите к нему выделенные адреса Proxeon с авторизацией по IP. И держите чеклист выката рядом: он окупается уже на первом инциденте, которого не случилось.